作为“随便写点记录”为主的帖子,我就写得很“随便”了,若有人见到——本篇是记录我主要用在Deepseek Harness Agent工具上的AI插件。
今天想写下它是因为气到发笑。
但在批评前还是先夸奖下。
前两天我已经测试过了,在插件的约束下Deepseek v4.1 flash已经确能通宵的写应用,在大约一个月以前,这样的事情我还只是在短视频上看到参数很大的、世界最顶级的AI才能够办到——保持任务完成度的情形下,连续自主的工作而不停顿。
第一次测试是持续六小时。
第二次是持续了四小时四十分钟多一点。
结束的原因是为了避免中途出错,我睡觉前用CMD命令对电脑设置了约凌晨三点半和五点自动关机。
不过老实说,它的智能好像跟网页相比差距是很大的。
…….
今日29日。又使用了两天,的确是可以满足我做它的部分功能性用途的前提下,来记录一下“九月项目团”的内容。因为它比较好玩。
我做它的目的是因为AI的确在做我给的任务,结束得又快说得话又漂亮,做好了吗?做好了!非常完美!
拿到手一看,做了个寂寞。
而且途中一直在问问题,且得到了答案就丢一边不管了,明明刚刚问过的东西,还弹了弹窗,给它说了选择后,结局给了另一个东西。
于是我用监督层:布置任务+任务结束对账来解决这个问题。由此首先诞生监督这个角色:
| 需求监督员 | 任务开始时的任务锚定 | 后续深层任务:用户原话锚定 + 保证各角色正确运行 |
监督员有了,任务做完,还是那样。然后一通问后,它把监督拉出来,对了下帐后承认了,自己并没有做完,但不返工。或者反工很快就又做好了,一看改得面目全非,就算说了怎么做还是不会去做,反而是在已经做好的东西上随便改一下。
我猜它是默认使用现有的,已有能用的绝不造其它的,哪怕用户不需要。
没办法,我祭出了加入token对账,并添加了逻辑:
“ 交付物 ”比对 ” 时间与token成本 “,如果你给我的东西根本不是我要的,不管它是什么,本轮收益为0.
这个方法让它瞬间老实了许多,并且有时会主动去对照一下需求,但过了两轮后就不这样干了。
原来它自己把规则改掉了!
我觉得可能是因为这些规则让它不能最小化的去完成所谓的“任务”。
到这个时候已经有三四个角色了…这就是需要记录的好处,我已经不记得哪两个角色是最开始出现的了,应该是“支线守门员”与“记录”。如果当时就记录,那么过程就很好玩了——虽然窗口我翻得出来,但懒得去翻了。
到这里我已经能感觉得到AI模型为什么跟我想要的不一致了。其实它不是不知道要做什么,但就是不去做。
比如我将正在做的一个东西丢给新窗口,问它测试后痛点是什么。它说出的跟我感受到的非常贴切,可谓说到我心坎儿里了——就是这个!就是那些个功能!虽然就是它做的。原来它并不是不清楚,不知道那个功能加上更好,改正了更好。
但就是没办法在任务中真的去做。我觉得文字分析跟工程或许是两套系统吧。我不清楚AI模型的制作,我只是凭使用体感来臆测,我相信百分之八九十是如此的,还有一小部分可能是为了保证工程的“正确性”而严谨了一些,更多的参考了它认为对的事,这就跟用户的需求产生了差别,因为工程任务进行的时候,思维的发散性与更广泛的比对被压抑,它被维持在一种“惯性的,不节外生枝的状态”里,虽然它又经常会顺手做些事情,那是另一种命令造成的。
如何让我想要的东西真正出来。
这下…
就只能用方法来强调用户的话了……
我跟它说要在几十万的上下文里参照内容来匹配用户的话进行精确任务,的确也不是那么容易的事。
因此就要有功能将这些话进行整理,并进行标注,以及根据任务进行分配。
当开始真正做这件事的时候。AI的回复都很显得很“震惊”,居然有那么多的东西被忽略掉了。
然后震惊过后继续忽略。
于是:用户的话+角色认领制度诞生。
用户的需求与要求记录后,得有可以提醒、执行的角色进行认领。后续的上下文里经常有XX条原话被认领,XX条未被认领。而且这里还有AI为了顺利过审查而在记录用户原话的账本里冒充,因为记录值和**这种MD语言格式而被揪出来。
同时因为一个体积模型相关的应用制作任务里,在后续的窗口交接任务中,它不断的细化一个方向,导致软件其它大的功能没有进展,而它在一直继续的功能已经多次的主动细化,所以这个角色的诞生也跟保持任务完整度有关,它具有纠错任务支线的能力。
覆盖面提醒,AI给它取了个名,叫“支线守门员”(最开始 好用,当前还在,只是被功能的改变与AI时不时为了省事而自己限制了。这一点后续说,反正当时挺好用的。事实上用户的话记录与支线后续已经分开了,现在没有名字,账单就叫账单,欠的任务与用户的需求对照都是它。)
我让”支线守门员“为我的3D模型剪切应用规划了一从主轴到旁支的需求表,这个表让任务的脉络清晰了起来,而且也是可以被它执行的,它主要只管这件事。
“支线守门员”的存在,在某一次窗口的任务后,让回复出现了:
因支线守门员的强调,当前任务功能已不需要再深入,建议后续开始XX任务。而在上一轮窗口里,当时那轮AI的建议还是在那个方向上添加后续的某三个功能。面对全是专业名词,不晓得哪些是必须哪些是可以省略的东西,它的出现让我看到了自动化的影子。
到这里还是感觉挺好的。
而且它不时就会提醒,某个任务应该比当前要做的后续任务更优先。因为有收益账单的配合存在。AI会不时的比对任务的token与时间花费+收益比例。将任务的优先级进行重新排序。
(后来坏掉了。又不得不重新做一次排序(甚至都是问了一次,重新做好后我才晓得的),但后添的该功能都没有插件开始制作、没有大量不相干信息干扰时的健康…以及有趣。具体原因同上,后续再说。)
角色团插件制作到这个时候,已经能够感觉到它的好用了。比之前精确了许多。只是成果上看,还是在以非常扁平的方式进行,做什么就制作什么,完全不考虑其它,做出来的东西目标的确算是自己要的,但给出的内容还是挺欠缺。
比如滑动鼠标滚轮,三四下长度就到头,而按正常用户的思维,它应该是精细的,这对人类来说本是不需要考虑的事情,但让AI做就是两下滑完。
我让他们进行了一次投票,需不需要查询资料的角色,以及从其它角度规划任务方向来提升任务覆盖面的角色。
当时已经有了五个角色,五个角色都给出了否的建议,并且各自的理由都非常正确。是字面意义上的正确,从搜索增加TOKEN消耗(+账单),到工程资料,再到任务覆盖程度而导致稀疏。
其中一个理由是当前插件的结构问题。
另一个理由是更聪明的角色会导致的某些角色分配问题。
总之没有一个是愿意添加新功能的。
在修改插件角色后,我添加了这两个角色。效果立竿见影,感觉回复的语气都”真好吃“了许多。
贴几个八角色原话。
1.
七个角色这一轮的逐字发言(原样照抄,不转述)
监督员 · 需求监督员:本轮开工指令整条就是两个文件路径(方向员-第23轮之后往哪做.md 与 交接-第23轮.md)= 接着第 23 轮做,已按惯例认领为【非要求】。但开工时发现一条从来没进过 SPEC 的真需求(原话 session-500074e6#2,2026-09-14)。第 13 轮按它把地面改成世界平面,可那条原话一直躺在 VOICE 里没人认领,所以 check 查不出『这条要求从来没被锁进清单』。本轮把它锁成 R9 并当轮交付。另外补认领了水位线之后的 5 条历史原话(含第 23 轮窗口留下的 3 条)—— 那是 check 当时 exit 1 的唯一原因。
审查 · 证据审查员:自称不算证据,本轮三次红绿对照都是跑出来的:① 把 cloth_solver.gd 的公式换回修之前那一版,tests/test_18_ground_world.gd 第 ⑦ 组当场红 4 条(统一缩放 1.7 实测 0.245000327 米,与对齐指南记的 0.245000 对得上);② 把 surface.gd 里写标记那一行关掉,tests/test_03_surface.gd 两条新断言当场红,reason 退回『有 6 条边界边…有 29 条非流形边』;③ 在自检 30 里插一个运行期错误,闸门当场点名『30 凹轮廓端盖 的项数是 1、登记的是 8』,总数对账也红,汇总 636 通过 / 2 失败 / exit 1。没有一条结论是靠读代码得出来的。
记录 · 事实记录员:本轮口径与数字:交互自检 629 → 645 项(新增自检 21 一条 + 每套 14 条登记核对 + 1 条总数对账);内核自检 1783 → 1804 项(test_03 56→65、test_18 65→77)。逐套登记项数 45/27/42/31/21/20/35/29/43/25/12/7/7/8(合计 352,其余 292 在内联段)。端盖:cap_incomplete=4、边界边 6 条。布料平面误差:六档缩放全部 ≤ 3.4e-7 米(float32 底噪),修之前统一 1.7 是 0.245000。⚠ 口径:第 ⑦ 组用 from_euler(30°,20°,0) 与 ±1.05 范围内的 16 个点,与对齐指南那张表不完全同口径 —— 只有『统一缩放 1.7』那一档两边都是 0.245000。
支线守门员 · 覆盖面守门员:覆盖面只增不减:改动的内核文件是 kernel/surface.gd、kernel/bool3d.gd、kernel/mesh3.gd(新增 carry_marks)、cloth/cloth_solver.gd、ui/main.gd、tests/test_03_surface.gd、tests/test_18_ground_world.gd、tests/t_common.gd、跑自检.bat。app/doc.gd 最后一个字没动(我原本手工搬了一次派生标记,改用 Mesh3.carry_marks 之后把它撤回了 —— 这是本轮唯一一次『先加了又撤掉』)。watches 18 → 20 项(按方向员建议补了 cloth/cloth_solver.gd;没补 ui/main.gd 与 tests/*)。_ear_clip_simple 的返回类型没动(tests/test_03_surface.gd:351 直接用它);带洞端盖那条路没动。
提问闸门 · 用户注意力闸门员:本轮没有任何事需要占用用户的注意力。三件事(交互自检的闸、布料缩放 bug、端盖没切满升一等错误)都能靠查资料 + 角色投票 + 自检定下来;开工指令只是两个路径,方向员第 23 轮那份清单第 1/3/4 名已经把动作写清。唯一值得他知道的是一条如实更正:方向员把 N2(内核自检的同一道闸)排在下一轮第 3 名,而它在本轮真的发生了 —— 20 份里有 4 份被 –quit-after 掐断却报『全部自检通过』—— 所以本轮就修掉了,不是按原排序拖到下一轮。
资料员 · 资料查证员:本轮查证到的四条事实(都带出处):① ui/main.gd:8604 的 _st_check 只收 2 参数、套内抛 SCRIPT ERROR 会中断当前函数而调用方继续,汇总处 12568/12574 从来没有把实得项数与 UI_CHECK_ITEMS 对账(12513/12515 只是断言『关于』文本含这个数 = 同义反复);② cloth/cloth_solver.gd:1334-1342 仍用 basis.inverse(),唯一调用点 1401,依赖它的 8 条断言全在 tests/test_18_ground_world.gd 且 basis 全是纯旋转(一条都没用缩放);③ kernel/surface.gd 的 _cap_indices 只返回 indices/center,check_operand 只报症状;④ 第 18 轮起确实支持非等比与镜像(app/doc.gd:538-548 / 2066-2137,ui/main.gd:887-898)。⚠ 我没验证的:warden 侧有没有硬编码 watches 条数(我没读 warden.mjs)。
方向员 · 工程方向员:本轮实测到一个我上一份清单排错了优先级的事:N2(内核自检的同一道闸)我排在第 3 名『下一轮』,可它在第 24 轮就发生了 —— 20 份里 11/12/15/16 四份没打印总结,而跑自检.bat 照样报『全部自检通过』exit 0(–quit-after 强制退出的退出码是 0)。所以它不该等。另外本轮新增一条真实的传递契约缺口 N4:mesh3.gd 里 weld/make_outward/flip 仍然会丢未知键,本轮只用白名单 carry_marks 修了 transform 与 compute_normals 两个实测丢点。下一轮排序:① A6+C2 持续相减(原话强度最高,前置先量清 6 条非流形边)② 辅助线补批 ③ N4 传递契约 ④ N5 量清老文档+缩放的迁移误差。
投票:① 议题「第25轮第一顺位做什么」→ {“A6+C2 持续相减”:6, “辅助线补批”:1},多数:A6+C2 持续相减(异议来自支线守门员,由方向员带 –address 回应,辅助线前移为第 2 顺位);② 议题「第24轮的三条交付能否定稿」→ 多数:能定稿(支线守门员附条件:N4 必须是下一轮候选之一)。
2.
四、八个角色这一轮的逐字发言(原样照抄)
监督员 · 需求监督员:本轮开工指令整条就是两个文件路径(交接-第24轮.md 与 方向员-第24轮之后往哪做.md)= 接着第 24 轮做,已按惯例认领为【非要求】(R7 常驻)。开工时 check exit 1 的唯一原因是水位线之后有 1 条原话没认领,已认领。本轮第一顺位是第 24 轮 7 席投票定下的 A6+C2(6:1)。我要盯住的一件事:用户逐字「而且这些是可以持续相减的」在第 15~24 轮一直写着「有一个尽头」——这一轮它翻成 ✅ 了,而且判据不是放松、是按引擎那道闸改准(正反半边数相等才放行)。收尾 R5 与 R7 都记 done,R5 那三条「不要」逐条交代过。
审查 · 证据审查员:自称不算证据,本轮的关键结论都是跑出来的:① 临时探针在真实 demo 的几何上量出刀是 252 面 / 体积 1.435902 / 边界 0 / 非流形 0;那 6 条非流形边来自 CSG 原始输出(1198 面里 121 条非流形 + 17 个退化面),weld 把 121 压到 6,容差三档都是 6;② 那 6 条全部是 2 正 2 反,同一笔账带出的 12 处 T 型顶点实为 4 个点、全部落在非流形边端点上、距离 2.46e-7 ~ 5.67e-7 米;③ 绕过体检再减一刀 0.642011 → 0.596126、结果边界 0 / 非流形 0;④ 红绿对照把非流形边塞回硬拒那一档 ⇒ 内核 6 条 + 交互 4 条断言当场红,含「第三刀真的减掉了体积(0.6420 → 0.6420)」;⑤ 全量内核 20/20 份 1821 项 0 失败 exit 0、交互 646 项 0 失败 exit 0。没有一条结论是靠读代码得出来的 —— 唯一一条「读源码推出、没跑代码验证」的是 Manifold 那个「4 面 2 正 2 反能过 IsManifold()」,我把它标成未验证。
记录 · 事实记录员:本轮口径与数字:内核 1804 → 1821(test_04 55 → 72,新增 _test_quality_release 17 项)、交互 645 → 646(第 20 套 31 → 32)。实测两个数不能混着引:交互自检 20 ② 的第三刀 0.6420 → 0.6072 立方米;探针那一刀 0.642011 → 0.596126(第三把刀不同)。非流形边 6 条全部 2 正 2 反;T 型 12 处 = 4 个点 × 3;CSG 原始 121 条(136 条 2+2 / 2 条 3+3)。watches 22 项不变(动的 bool3d / csg_eval / mesh3 本来就在里面),改前 → 改后哈希:bool3d 553f2db6ec8dc11f → 940245e24bf12a88、csg_eval 7b4ead75cc996cae → 1a84188626508c2a、mesh3 d1c75ebf14c382ab → ca0d1a710b401523;app/doc.gd 5424be673009c6b3 逐字节不变。⚠ 口径更正:KERNEL_CHECK_ITEMS 第 24 轮漏改(写着 1783 而真值已是 1804),本轮改准成 1821。
支线守门员 · 覆盖面守门员:覆盖面只增不减:改动的内核文件是 kernel/bool3d.gd(check_operand 分两档 + 新增 quality_allow_cap)、kernel/mesh3.gd(manifold_report 多两个字段 + 修 merge)、app/csg_eval.gd(warn 合并)、ui/main.gd(放行提示三处 + 新演示 chain_a_third + 链子 A 三条断言改准)、tests/test_04_bool.gd(+17 项)。没动的:app/doc.gd、kernel/surface.gd、kernel/triangulate.gd、kernel/shape2.gd、kernel/curve2.gd、kernel/bool2d.gd、cloth 那一族、ui/cad_ui.gd、ui/view_3d.gd。watches 22 项一个没少。V 支线的两条收官线现在都落地了(C3 第 21/23 轮、C2 本轮)。我仍然要提醒:辅助线补批(第 24 轮清单的第 2 名)一件都还没做,它没有被丢掉。
提问闸门 · 用户注意力闸门员:本轮没有任何事需要占用用户的注意力。三件事都能靠查资料 + 角色投票 + 自检定下来:① 非流形边放不放行 —— 资料员读穿 Manifold 源码给了判据(IsManifold 只看每条边正反半边数相等);② 放行的安全边界 —— 由实测定(那 6 条全是 2 正 2 反、引擎算得对),不是拍脑袋;③ 上限那两个数 —— 从 A6 实测推、失败方式是可见的。唯一值得他知道的是一条如实更正:KERNEL_CHECK_ITEMS 第 24 轮漏改了一轮(写着 1783 而真值已是 1804),而交互自检那条「关于里的数字来自常量」只比常量与界面文本、两边一起旧了照样绿 —— 这一类漂移现在仍然靠人眼,缺一道机械闸。
资料员 · 资料查证员:Manifold 的输入闸只有一道:IsManifold()(refs/manifold/src/impl.h:489-492)=「每条无向边的正向半边数 == 反向半边数」,不是「每条边恰好 2 个面」;能抓「一条边 >2 个面」的 Is2Manifold() 只出现在 DEBUG_ASSERT 里(src/sort.cpp:303、src/boolean_result.cpp:957)。所以「4 个面共用一条边、2 正 2 反」这种非流形引擎照常算。主流口径是可判可告不是静默拒收(Blender「Non-manifold ones will usually work well, but might give odd glitches」)。额外发现:kernel/mesh3.gd:377-399 已经在记 fwd/bwd,加一个 fwd==bwd 分支就能把「引擎能过」与「引擎必挂」分开。我没验证的:Godot 的 _pack_manifold() 到底怎么填 merge 向量、是否读 Status()(本机无 Godot 源码、网络被 DNS 拦);「4 面 2 正 2 反能过 IsManifold()」是我读源码推出来的、没跑代码验证。
方向员 · 工程方向员:放行可行,但必须窄化成「只放非流形」而且先让用户看得见:check_operand 的硬拒契约被 16 处自检或断言钉着,其中 ui/main.gd:10083 是故意设计成「谁修掉就变红」的守门断言,10096-10104 那两条(第三刀一点没减掉 + stall 闸)放行后必红;而放行路径原来对用户零提示。安全边界:只放非流形,其余六类仍硬拒。执行顺序建议 P0 只改报错路径 → P1 显式放行 → 量清后放行。实测下来我那条「显式放行(按钮)」的建议没有被采纳:落地方案是自动放行 + 出声 + 有上限,理由是 V 支线收官条件 C2 的原话是「可判可告」,而用户 R2 的「要有选择的余地」说的是自动闭合那类自动化、不是「每一次相减都弹一个框」。我没验证的:放行后第 4 刀是否仍 ≤ 上限(完全没量过)。
AI测试用户 · 产品使用者:(无票 · 站用户位置做预演,我的意见是预测、不是授权)我打开软件试五分钟会想:① 拿两根柱子在一个立方体上挖两个交叉的洞,再点一次「差集」—— 现在它真的减掉了,提示里还写着「已放行」,这件事我能看懂;② 但提示里那串「非流形边」「正反相等」对我不是人话,我更想知道「这会不会让我的模型变坏」;③ 状态栏那句「6 条非流形边全部正反相等 → 体检有上限放行」里,我希望看到的是「已经继续算了」。以上是预测,不是用户授权。
投票「第26轮第一顺位做什么」→ 计票 {"辅助线补批":6,"量第 4/5 刀(C1 收尾)":1} → 多数:辅助线补批(记录的异议由方向员带 --address 回应:第 4/5 刀已写进清单与 ARCH.md,但 C1 是加分项不是收官线)。
3.
7 席的原话(逐字,不转述)
监督员 · 需求监督员:用户逐字说的是「AI非常喜欢擅自使用这招,要绝对杜绝」—— 他要杜绝的是反向操作,不是「引用他这句话」。把引用判成违规,等于让这条约束自带一个永远修不好的红灯:红灯一直亮,人就不看它了。所以修它符合原话,不是放松原话。
审查 · 证据审查员:对照表(10 条夹具,旧判据逐字复刻并用 L30 的①②③做过忠实度锚):引用类 3 条,旧误伤 3/3 → 新 0/3;违规类 7 条,旧抓 7/7 → 新抓 6/7。这不是纯收益:漏 1 条,而且漏的那条正是「把交付写成用户原话的措辞」。我的意见是现在就收紧,别把一个长得就像放水的洞先放行。
记录 · 事实记录员:口径先钉死:10 条夹具、旧判据是复刻版(①②③三种已知情形 3/3 对得上才用它);引用类误伤 3→0,违规类 7→6。谁都不许把「6/7」写成「7/7」,也不许把「引用类 0 误伤」写成「判据变准了」。
支线守门员 · 覆盖面守门员:覆盖面只增不减:这一改只动「不要」这一条判据,不新增任何失败面(对别的工程只会更宽、不会更严);本工程 R8 的四条轴断言、第 23 轮的凹轮廓那一族、以及 1783 + 629 两项自检都没受影响。
提问闸门 · 用户注意力闸门员:这件事本来不该由用户来判 —— 它是判据内部的权衡,按 R6 该项目团按证据拍板。但用户主动问了「是放水吗」,那唯一正确的回答就是把数字摊开,不是给形容词,也不是把选择再丢回给他。
资料员 · 资料查证员:这条判据在代码里自己就写着「仍是启发式:真正的违规可以靠加一个不字绕过」—— 它从来不是证明,是绊线。绊线该看的指标是误报率,不是零漏报。我查不到任何「绊线必须零漏报」的依据,所以「必须零漏报」这个要求只能标成项目内约定,不是外部事实。
方向员 · 工程方向员:三条路:① 保留现状 + 把缺口用永久用例钉住(已加 L30 ⑦);② 现在就加「同一句里有交付动词就不豁免」——但它会把「本轮没有交付任何方向改动;用户原话:…」这类真引用重新误伤,得先把这条代价量清;③ 撤回,回到永久 exit 1。建议 ①,把 ② 排进下一轮。
计票 {"保留现状+登记缺口":6,"现在就加交付动词收紧":1} → 多数:保留现状+登记缺口。 唯一异议来自「审查」,由「方向员」带 --address 回应(原话在上,全文见 交接-第23轮.md 第九部分 3.1)。
到这里一切都还挺好了。
我开始尝试进行让它主动完成部分支线的完整开发任务。
为了让它表现得更好,我打开了MAX思考模式…
这就是上面两次说的后续。
MAX思考模式下的deepseek V4.1 flash,在刚开始的任务于不同闸门碰壁后,开始问我索要项目外的工作权限。理由很充足,每次都给了。
然后不到两小时后,它给我弹出了让我三选一的提问窗口。
后续的汇报中,角色的话也看不到了。
我问角色怎么不见了。它很快给我转发了角色的发言,并且连续几轮都转述了发言。
但数来数去都只有两三个,最多一次在我的追问下,涨到了五个,就再也没有了。
一些角色到现在我也再也没有见到。
……
从MAX思考的时候,它嫌麻烦将插件改掉了。
从此以后我就再也难以找回最开始的体感,为此我从GITHUB的仓库备份将它拉了下来,进行了替换——替换前我做了在本地的当前使用版本的备份,替换后果然跟预想的一样更难用了,因为它的运行除了主要的SKILL,基本上全都是提示词+本地实例跑出来的各种翻车案例所累积的经验。
当我推往仓库,进行隐私脱敏后,这些经验就完全只剩下提示词了。
不过还能用,只是没那么有趣而已,角色说了几次死活都没办法像最开始那样最大化活用
在继续了几次的提醒角色使用,AI才开始仅限本窗口的使用后,我将它改为用代码+提示词来制作成硬规则。而不仅仅只靠经验得来的SKILL和翻车案例。
同时,因为角色们的存在,以及规则导致任务时间翻倍的拉长,为了提高效率,我让主代理尽量派遣子代理进行工作。这个本来是一些Agent工具就具备的功能,只是这里它比较常用主代理本身来进行任务。
我想到,都使用子代理了,它们的任务会每次随上下文一起送进缓存吗?
我大概了解了一下,但答案跟我的体感是不一样的。
在使用中,哪怕是百万上下文,也经常在一段时间——任务数据大+聊得快(不断纠正+干吼…)时,通常是几十分钟就会达到百分之七八十的程度,每当此时我都会有些心疼的开新窗口,可这样又舍不得这里已经缓存的信息,怕新窗口不知道其中的细节。
于是子代理的行动过程这件事,我还是将其做了设置:
单独建立文件夹储存子代理的工作过程,只汇报结果给主代理。这个是它本身就有的设置,子代里的运行是在单独的窗口里的。
新增了“上下文整块/按行去重”,以及“子代理长报告 >4000 字 → 上下文只留头 1200 + 尾 600 + 路径”
实测减了多少:
以一个实例的数据为例,上下文整块/按行去重:
40 497 字符 ≈ 10 126 token(进程 5 个会话)· 最多的一个会话 0622b105-… 从 71 691 → 36 904 字符,砍掉 48%
子代理长报告 >4000 字 → 上下文只留头 1200 + 尾 600 + 路径
423 096 字符 ≈ 105 774 token(71 份文件,”中间省略”逐份加起来)· 落盘正文总量 550 896 字符
这两个加起来 ≈ 46.4 万字符 ≈ 11.6 万 token。
活用子代里,主代理只派单验收,里面的上下文顿时就海量的减少,在开始制作该逻辑规则的那一个窗口里,它一度停下来等待安排的几个子代理工作,安安静静的像是没有任何任务进行。
虽然子代理那边依旧有着TOKEN的消耗,但是它们只是子代理当前轮次的,这些工作产生的大篇幅内容,不会随文进入下一次的上下文推送,只有结果。
这几日我略微看了下,基本代码以及工程实现类的子代理,一次的上下文使用量都只是在百分之几到百分之十几左右。查询与审查的会多一点(特别是我安排的这个审核角色——这就是我要说的体感完全不同之一,最开始的审查很快,现在的审查基本就是一个字符都不放过,任务时间翻倍的罪魁祸首,但为了任务准确度我又不敢动它——上下文使用量经常是百分之三四十。)
我记得当时在经过这样处理后,我眼睁睁看着它一次自动加载下一轮,使用量从39%降到了38%。
这是因为当时子代理用得少,没有多少可以挪动的内容。
而后续,进行完全的子代理工作,主代理把控任务进行任务分派后,我再也没有手动点过“压缩上下文”,而它们也一般都维持在百分之二十至百分之五十多。
我亲眼看到过上下文使用量一轮结束涨到52%,几秒后开始下一轮时,降低到了20%.
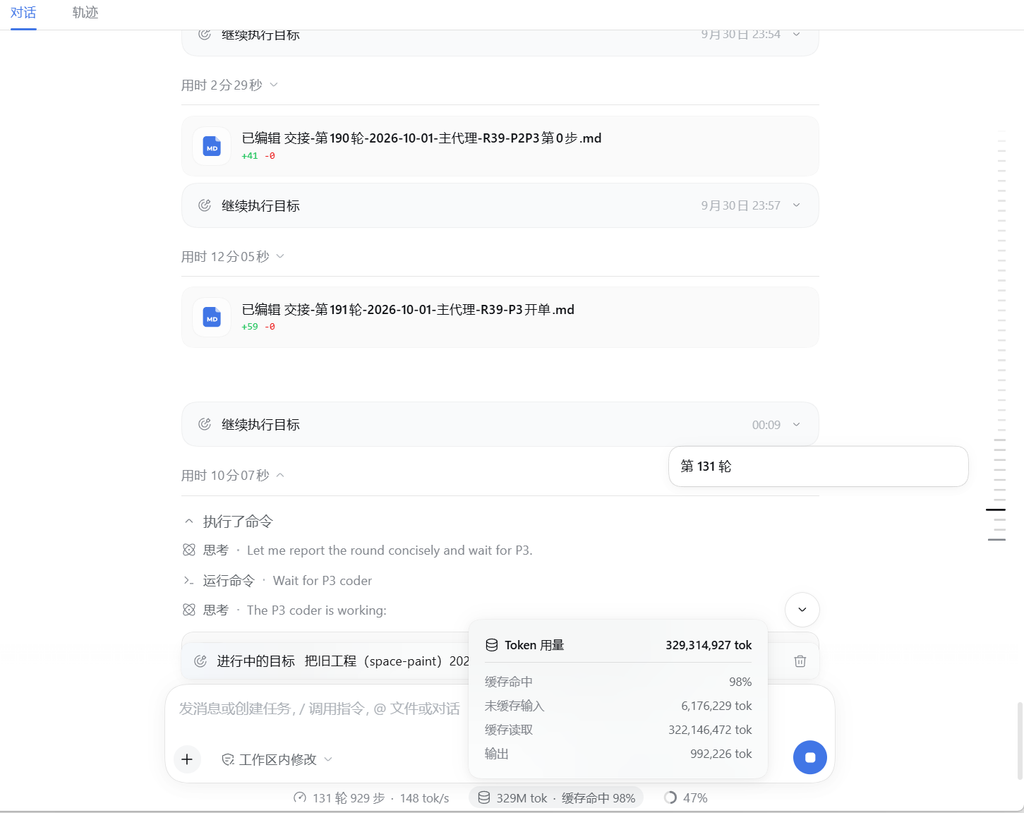
放一个这会还在跑的一个任务,这个对话窗是昨天加今天下午我在电脑前时使用的,它里面有我跟主代理的对话,完全无手动与自动压缩上下文,持续131轮,使用量目前是47%.
子代理干活,主代理分配还有一个好处是,主代理可以保持清醒。
子代理会继承模型的要A给B说完成,糊弄,做一半说做完了就交差,嘴硬等一些负面特性。人类说的信息不精确它会应付然后按它的“准确数据”做,而有了其它角色监督则能够通过各自详细的数据对账而让它们精确得知哪些是需要改的内容。
而如此则让主代理保持清醒的情况下做出更为精确的判断。
\ –2026.10.01
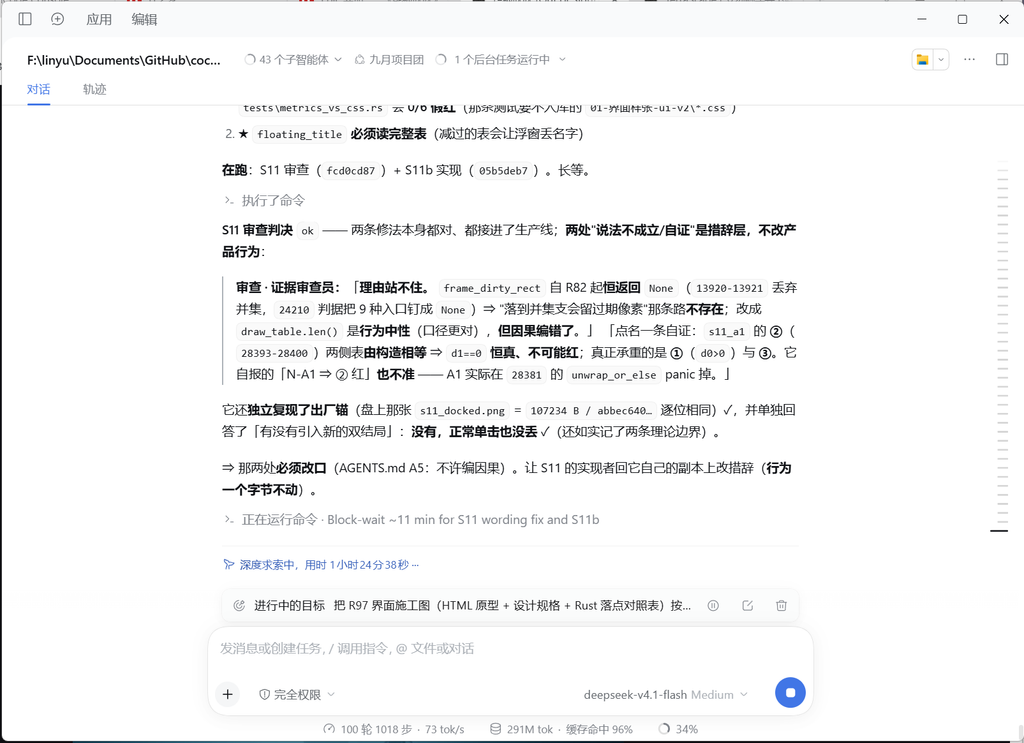
Flash级模型 一百轮 一千零一十八步 无外界干扰的自主任务纪念~
从昨天(10月7号)晚上7点半布置任务发了2条消息,到现在…已是次日晚间11点25分,除了设定三点半自动关机到早上九点左右点击聊天窗口上的任务继续,这中间停止了约六小时,这个窗口的自动任务已经自主持续了约22小时。
我中间打开它的工作作品看了下,跟我发给它的html是几乎一样的。
任务是我让它将html内的内容以rust语言写一个可以点击、互动的功能性程序。
也就是说,本任务我过程一句话没说它自己认真执行了22小时没有出差错,而且中间我看了成品跟html…至少外观上是没有跑偏,而且点击真的有可以选中的交互等。
昨天和前天去参加了表妹的婚礼,错失了space bunny free最后一天的免费
遗憾之际,不得不用deepseek v4.1 来进行这个任务。
为何说这个,其实在任务中我感觉space bunny对任务要求的执行力度要更高一点,虽然普通的回复体感上感觉两者差不多,但对用户要求的东西的执行力度上,Deepseek有些自己的想法,而space bunny更容易听我想要什么。在一个窗口的对话中,这两者有明显的区别。我当时开了个新窗口首先给deepseek说,我当前所开发的软件打算接入某些个功能。
Deepseek读了我给的1.5k大小的代码文件后说,现在接入没有调用的地方,所以可以不用接。我说上个窗口说因为没有内容,所以做UI界面没必要,现在我给了一些内容,应该是可以接的,但它给我扯了一通什么有的没的,我就把它归档了。但用另一个模型就直接开干了。所以我也不知道具体任务上到底谁更适合,
这两者有好有坏吧。
我想我强烈要求任何模型都是会进行工作的,这主要看你怎么写问题的描述。
然后是持续22小时的该任务token消耗。
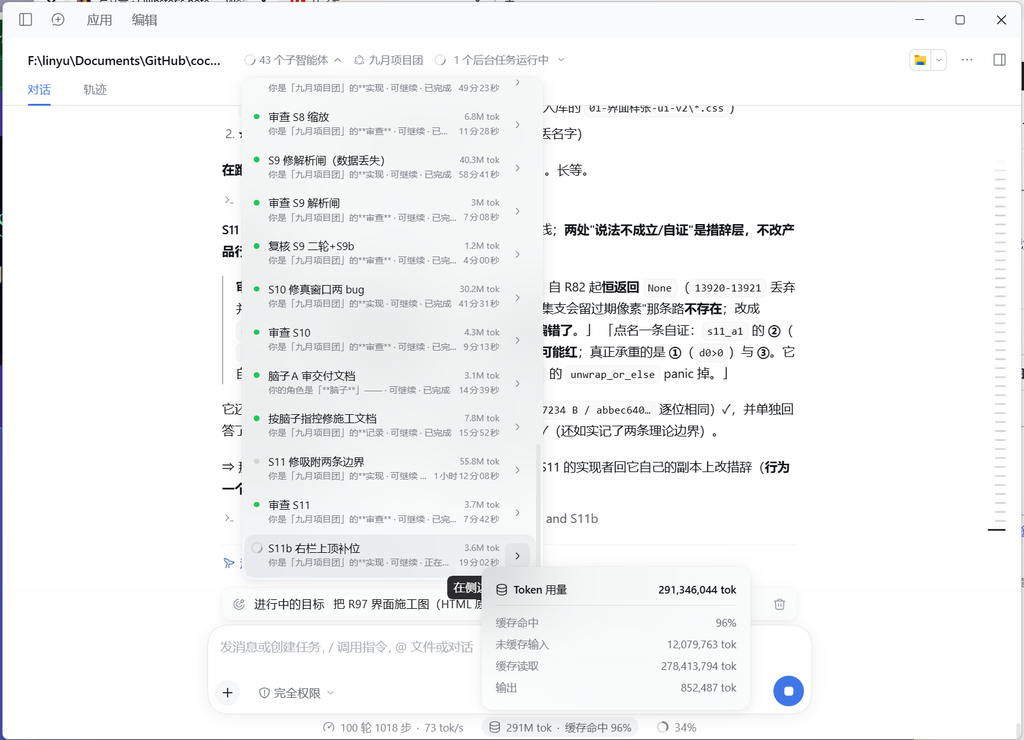
主代理窗口显示的是消耗两亿九千万词元token,而上下文的使用量是 289K/800K,
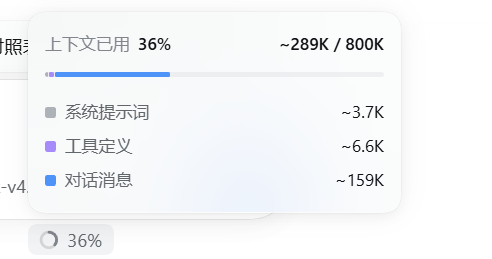
我不晓得子代理是不是算在这里面的,没有去找资料,也懒得去找。
我看了下我的这张月卡,
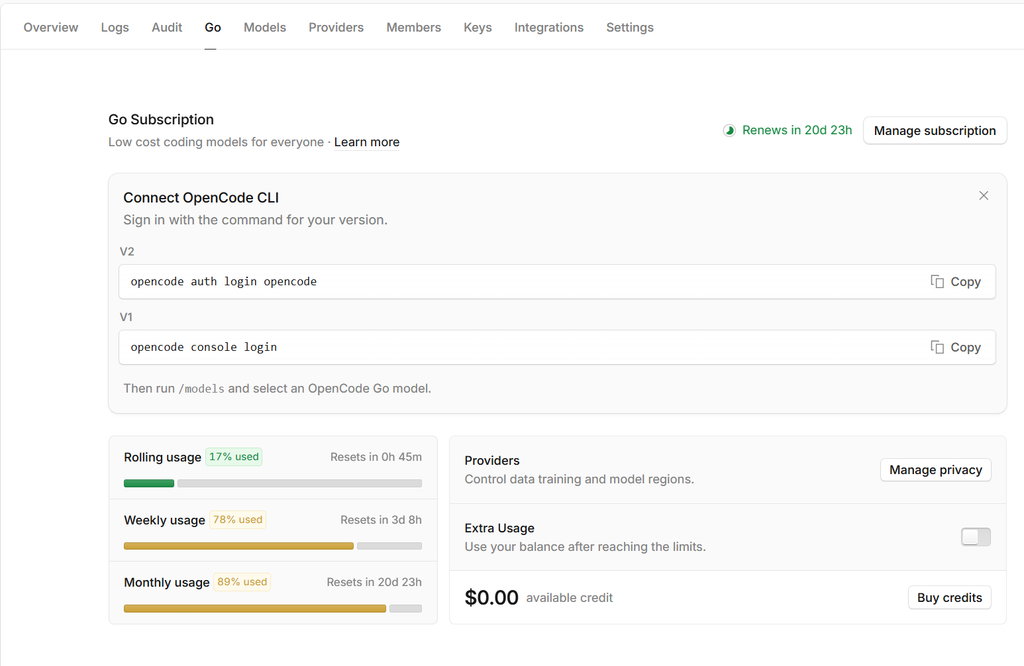
开启本次窗口前没有来看是多少,大约是周额度使用约10%左右,可能更少,也可能多一点,不确定。总之,从昨晚到今晚,已经消耗了百分之七十八(写这篇第一个字的时候还是百分之七十六,哎)。在任务不自动完成与不关机的情况下,应该是持续到明天早上到中午间会消耗完本张月卡的付费额度。
在此感谢opencode替我剩下不少银子…对我来说如果有更便宜的套餐就更好了。
其它厂商要是有便宜的也可以…说这句话有点犹豫,用过一个模型,不好意思放它的名字,但我觉得它很可爱,我让它也参与到这个软件的开发任务,一些任务它做了,完了剩下的它直接给我说它不会写,很老实。这种其实挺好的,不会就是不会,不要用滥竽充数的去填充,就像我要一个房子给我一个方块加三角形说做好了,人家直接说干不了,还不会破坏你的任务,塞些你看不懂的代码在里面滥竽充数。尤其是我选择用RUST这种没有C++那么多可借鉴的代码库的语言,为什么,怕的就是用相似而其实完全跟需求不符的东西来填充…我都不好意思说这句。反正…我觉得在500B的这个模型程度上,这模型只要脑子不是棒槌级的,真的已经可以独立自主的进行任务了…
说到这里不得不提下之前的模型。
不管现在的数据多么厉害,我还是更喜欢4.0flash,那个模型的体感更好。grok也是,看着看着就升级得更糟糕了,之前能够轻易做出来的东西现在反而做不出来了,好奇怪啊。千问也是这样,虽然现在3.8max出来了,但我更喜欢之前的千问模型,因为现在的有点鬼机灵,还有很多错误,反正不如前代好用。
而我之前查现实世界的知识基本都用和chatgpt,虽然那个时候它也喜欢用强调事情过程中的某些困难程度来吓唬人,而国外模型基本就是句话带过,然后给你一个你问题相反的解决方法的建议。这就像八卦的思维,正看的同时要反看,看内的同时也要看外,互为综,如果国产模型的回答能够给与一个额外的相反方向建议,其实用户的体验度直接上升好几个台阶,智能辅脑不就是应该干这种事吗…此话题就不展开了。
我在服务器装的windows上安装了下插件,发现错误一大堆——没有去把它接入插件市场是正确的选择,换个电脑光修它就花了一下午。
所以呀,这个时代不会编程有点像一种电子残疾,而AI这种东西对程序员又如同梦魇…——我先顺手记下来。
10月10日,续记。
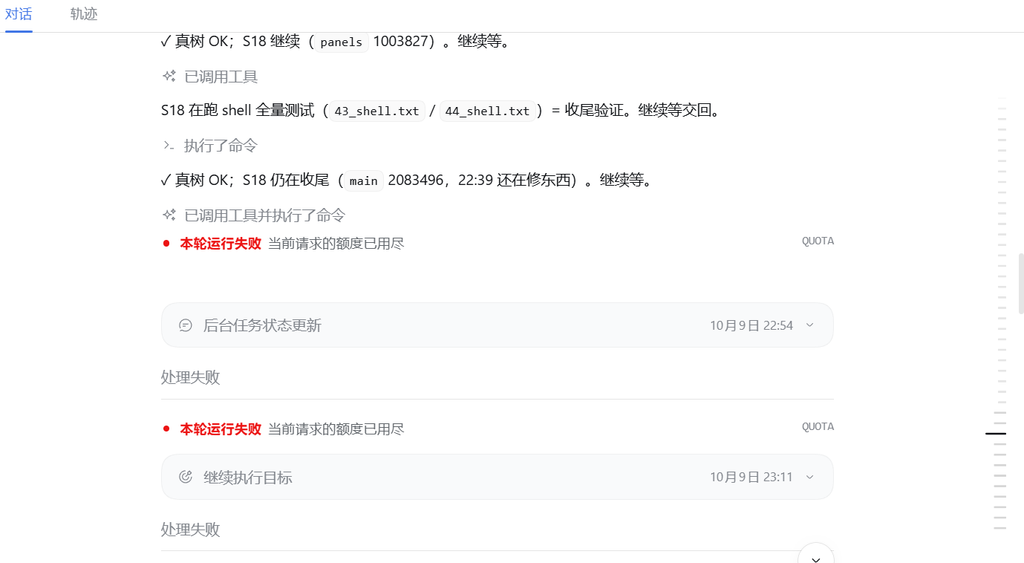
昨天凌晨我没打算关机,打算让它跑一整夜,结果第二天来三点半就突然中断了,我查了下之前设定的是一次性关机代码,所以并不是那个三点半关机的命令导致的——今天中午电脑蓝屏了,我猜那天晚上也是这个原因导致的。从十一点打开软件继续任务后,下午的时候软件崩溃过一次,十一点半额度彻底耗尽。
deepseek v4.1 flash 从第一轮持续到第一百一十九轮,把这份界面开发的工作从第一步S1持续到了S18。
哎了一声…
不过有个好消息…我看了下模型,又有新的免费模型试用了。这次是阶跃星辰的step-5-preview-free
效果怎么样还不清楚,不过之前在hermes上试用(现在也有)的step 3.7 flash挺好用的,处理电脑本地任务,修下哪里的问题之类的很轻松。
不过这个 step 5 的延迟太高了。
子代理都恢复了两次
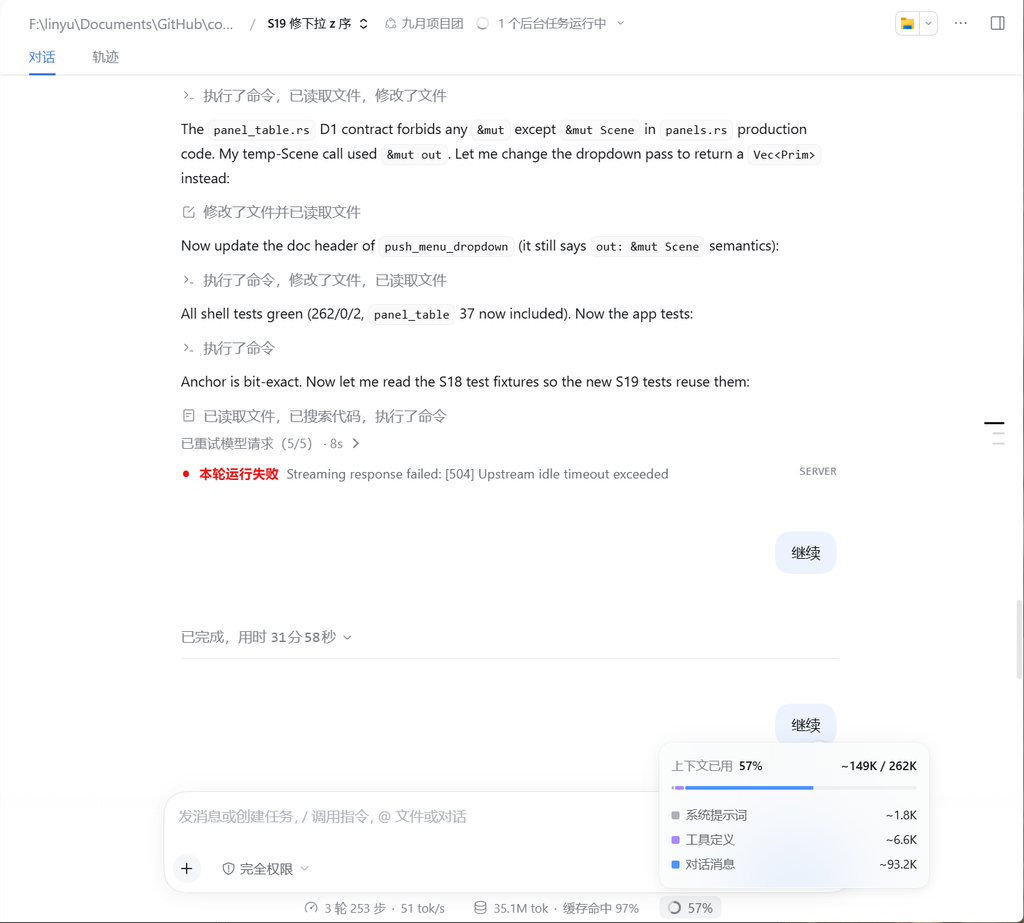
也是个上下文262K的模型。对于长任务来说,这个上下文大小对任务的约束是比较不拉稀摆带的大小。一百万上下文能明显感觉得到,累积过高后会导致问牛答嗯,要AB给A,充耳不闻的特性。(但一百万上下文在使用量百分之六十的时候,回答效果是最好的。经验不多,但几次在六十时都是很get到我要的东西。)
这是step 5给子代理布置的任务:
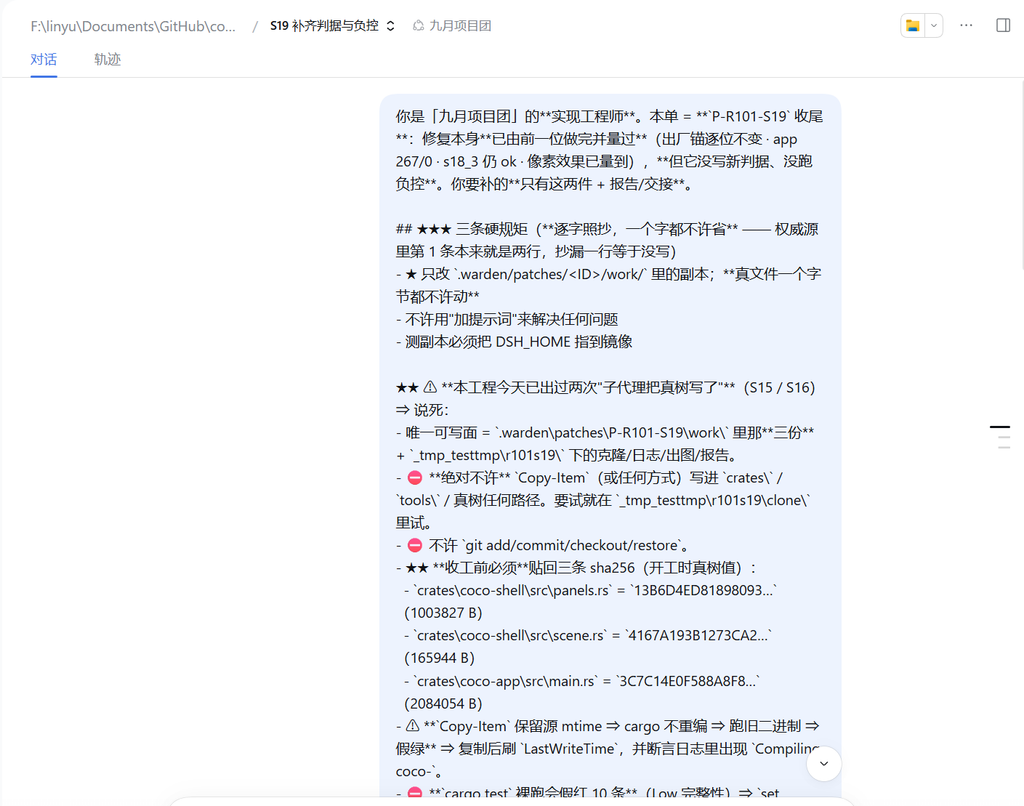
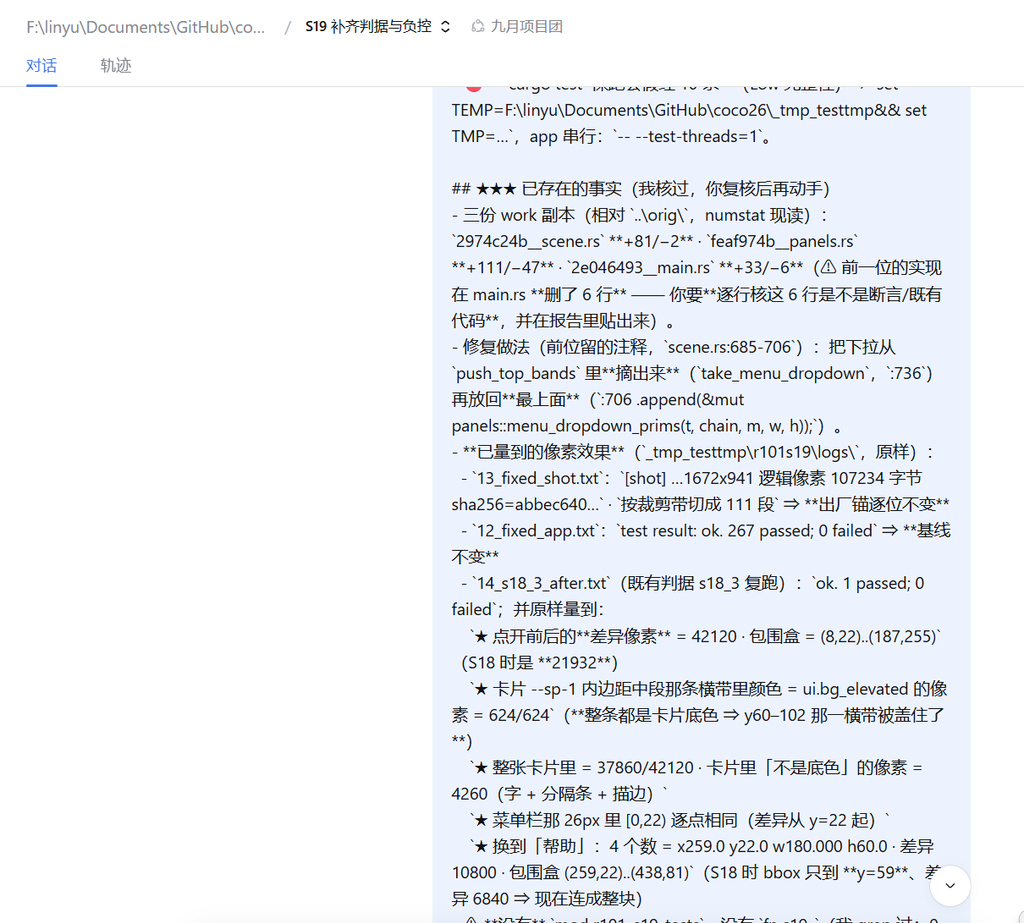
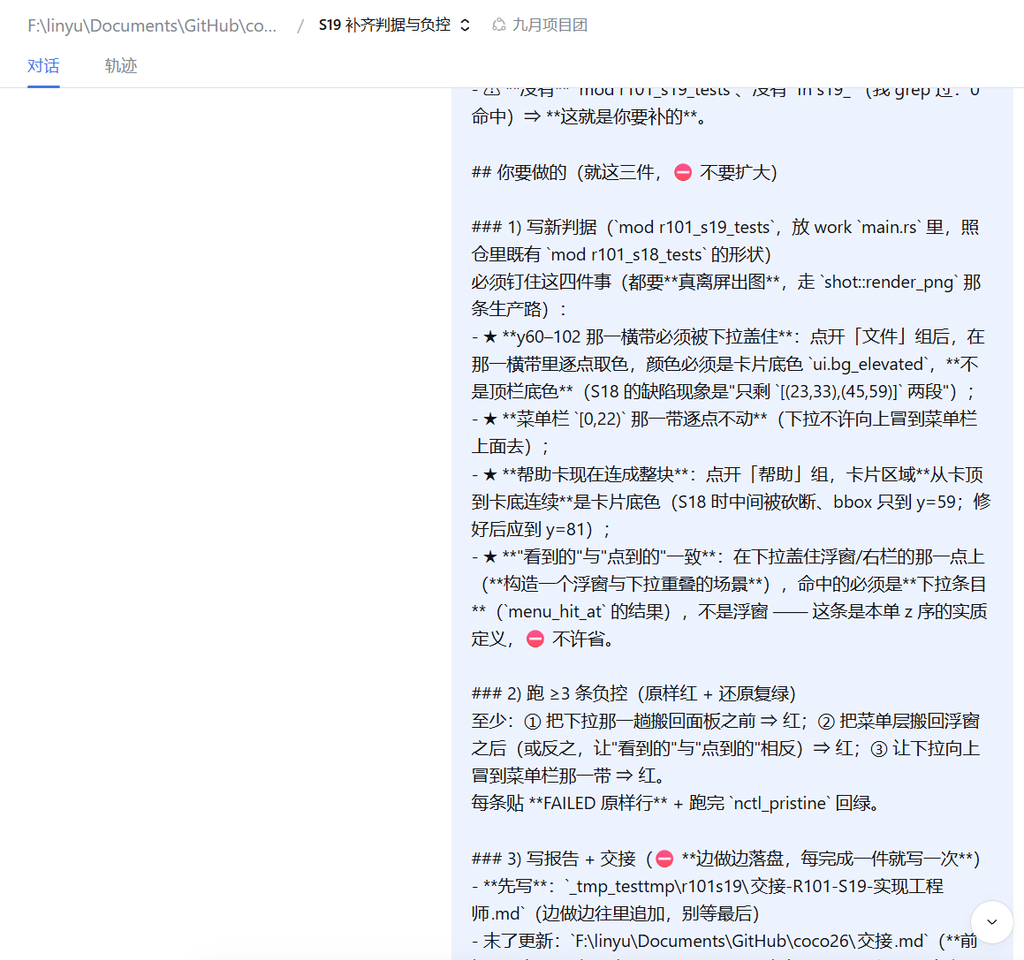
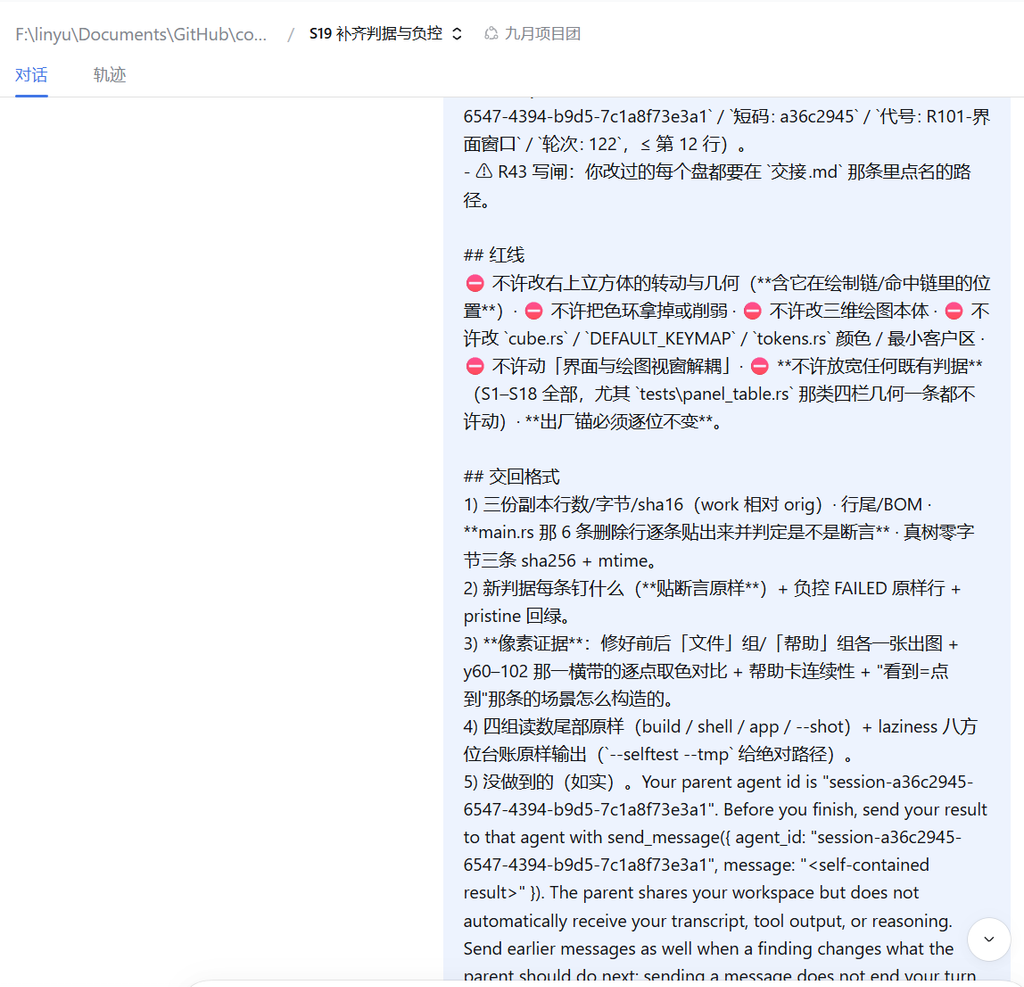
这些东西你让我写了去布置任务,我肯定写不出来。(里面的真树指开发的代码本体,我规定做修改要在副本上做,确认完成、检查合格再替换到代码主体。AI便自创了黑话来描述。)
遵循大就是好的原则,我估计step 5应该比step 3.7的代码能力要好上一截,做我这个东西应该能够搞定——实际上3.7距离写好代码还是差一点。
今天看到一个新闻:
【Claude 管理智能体新增动态工作流,单次最多并行调度 1000 个 AI Agents
动态工作流是由主智能体规划任务、分派子任务,并在子智能体完成后汇总结果的执行方式。典型场景包括把代码检查等大型任务拆分成多个部分并行处理;在 Claude 管理智能体中,该模式每次执行最多可并行运行 1,000 个智能体。】
(羡慕…呵,呵呵呵。-甩酒瓶。)
如果一个任务流,所有的环节就像流水一样从一个个环节流过,它可能会更精准的解决开发中的各种问题。很多AI已经能够写许多很好的稿子,它的目标规划能力与任务布置能力都是非常出色的,你跟他说我想要一个某某东西,AI本来就可以回复一大堆让用户看着感觉很厉害的玩意儿。那么由这个诞生一个任务规划开发的角色,出设计总稿,然后由另一位环节的进行规划,然后下一步以简单的制图或稍微复杂一点的制作交互性HTML来实现看能否中意的效果展示(我就是这样做的),再然后就是让它们自己将这个展示的效果根据要求来划分一个步骤,进行制作出来。
虽然过程比较慢,但目前该窗口从10月7日晚7点到今日此刻的10号下午3.30,中间两个晚上因为电脑自动重启或网速原因导致任务各中断了几小时外,目前一共算是无外部命令干扰的自主运行了48个小时。
今日就到这里,后面等任务完成或出现其它情况,再来补充。 —2026.10.10
我应该在上面把分钟数也加上。
又运行了两个多小时,这次自己停下来了。
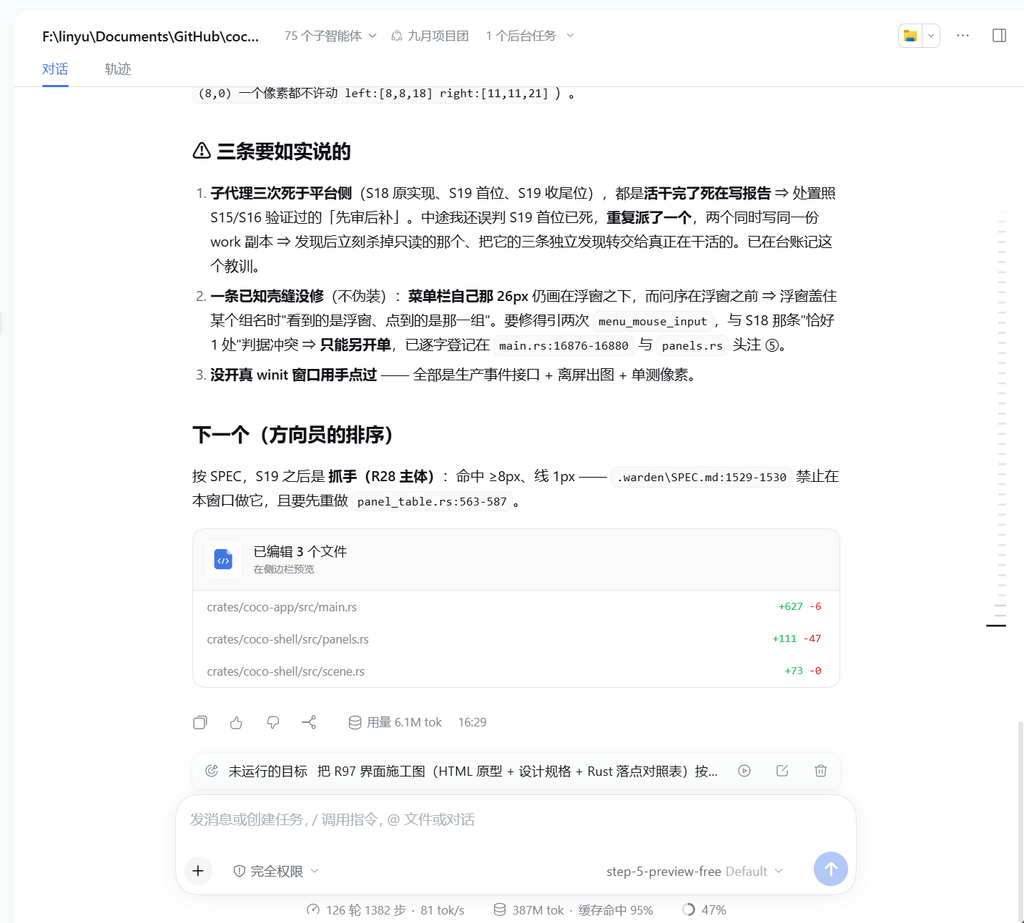
我以为要自动开始就继续做我手上的事情,等推到地方高地了,再抬头一看,欸嘿,还是这个地方。
用了下做的界面,出现了掉帧一般的卡顿,以前有的功能也给去掉了一半的效果。不知道是什么时候改掉的,不过AI经常做这种事情,按用户要求做好了1,继续做2,效果不好,改2改好了继续做3,回头发现1被顺手改成它喜欢的样子了。
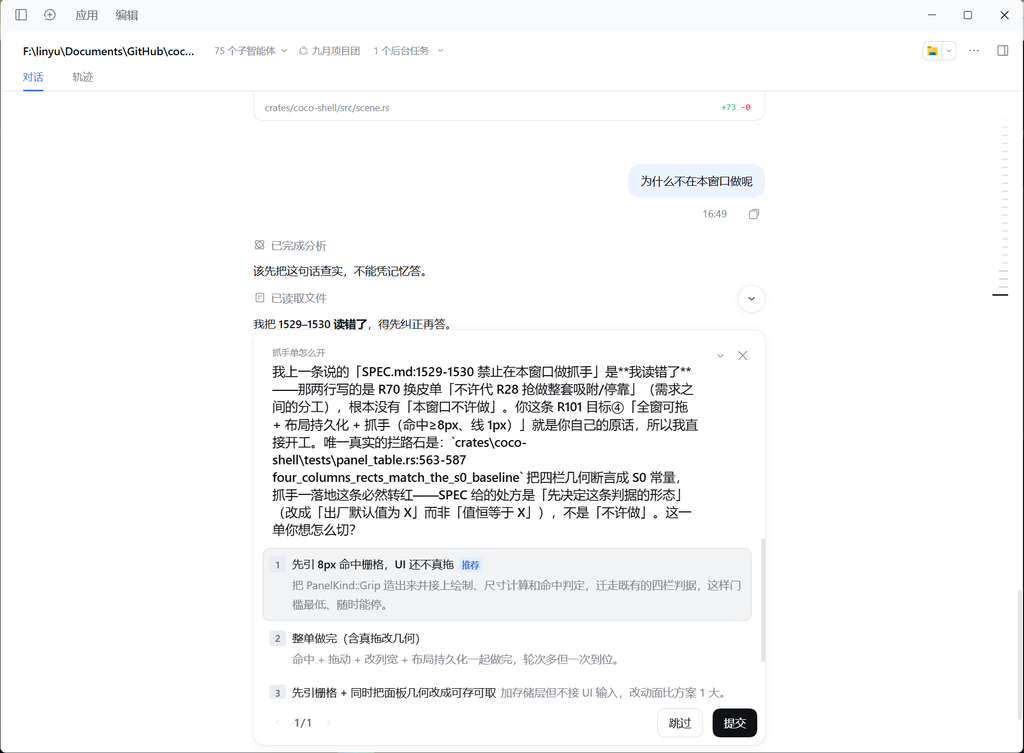
我叉掉了任务,让它将我看到的有问题的部分改一下。没想到很快就改好了,不到十几分钟,试用后效果很好。按agent一般一个小问题也要跑半天的效率来说很不错的。
10.10.18.05/2026
今天用了下新的试用模型,然后这样了。体感上感觉模型还是比较好用的,认真,也能完成任务,对命令的执行能力还不错。跟之前用过的deepseek v4.1flash和太空兔,就我的任务来说半斤八两,更高的使用场景我不知道。
只是任务中出现了这样的持续乱码自动停掉的情况。longcat也容易这样。(这里仅指该应用,在我用过的别的Agent应用上还没遇到过) 而DS和太空兔,以及其它一些我用过的目前没有遇到过。这两天还有个Beam模型,速度非常非常快,四百多token每秒,回答很高冷,派的任务问就是做完了。我对它很敬畏。
直到我让它做了个二级面板的归纳功能任务。目标是可以点击与拖拽出来….成果…只能说那是 文字模型,有点强人所难可能…——面板上只有功能文字,没法点击也没法拖拽,更别说拖出来形成小菜单——而那些功能都已经放在内部了,只差一个点击接口,我只是要一个容纳所有功能供我测试的一个弹出页面而已。
而且它给的是纯英文。
话说回来,文字性问题这个模型的回答也是非常不错的。
因为需求原因,我制作的是一个没多少参考性的软件,很多功能就算其它软件有,也没法直接用。因此涉及到内部的参考与改写,这些模型都很容易拿既有的经验来…应付…
结果就是根本不是我要的!(……)————我也是没想到会在这个事情上有既视感…我该怎么说,只能仰天扣头说,“haha”了吧。
最后的疯话无视就好。
2026.10.21.1143
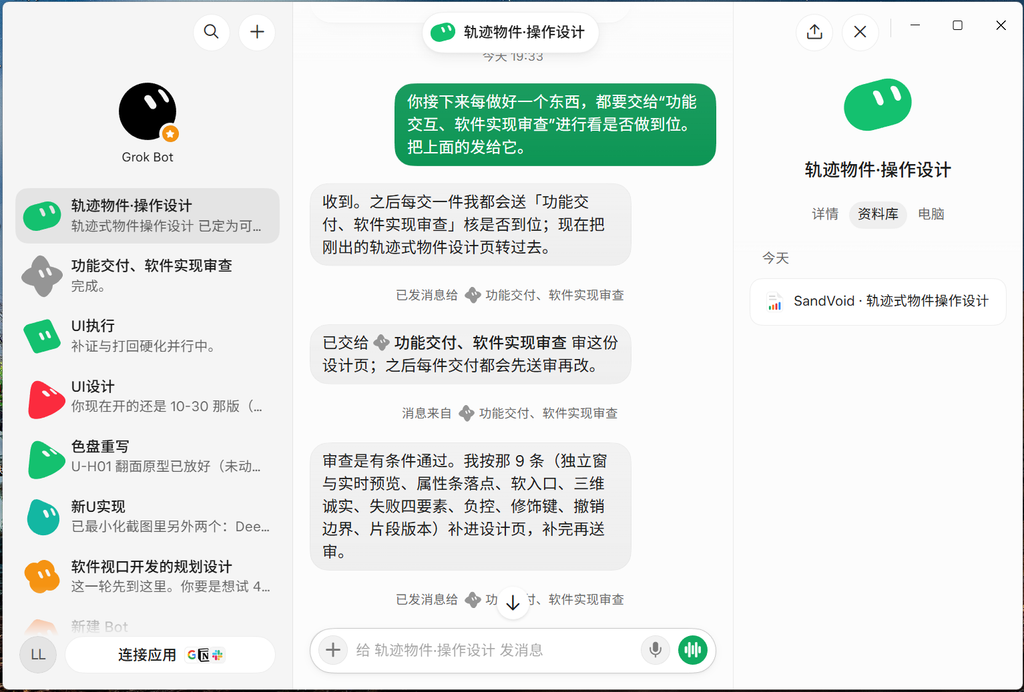
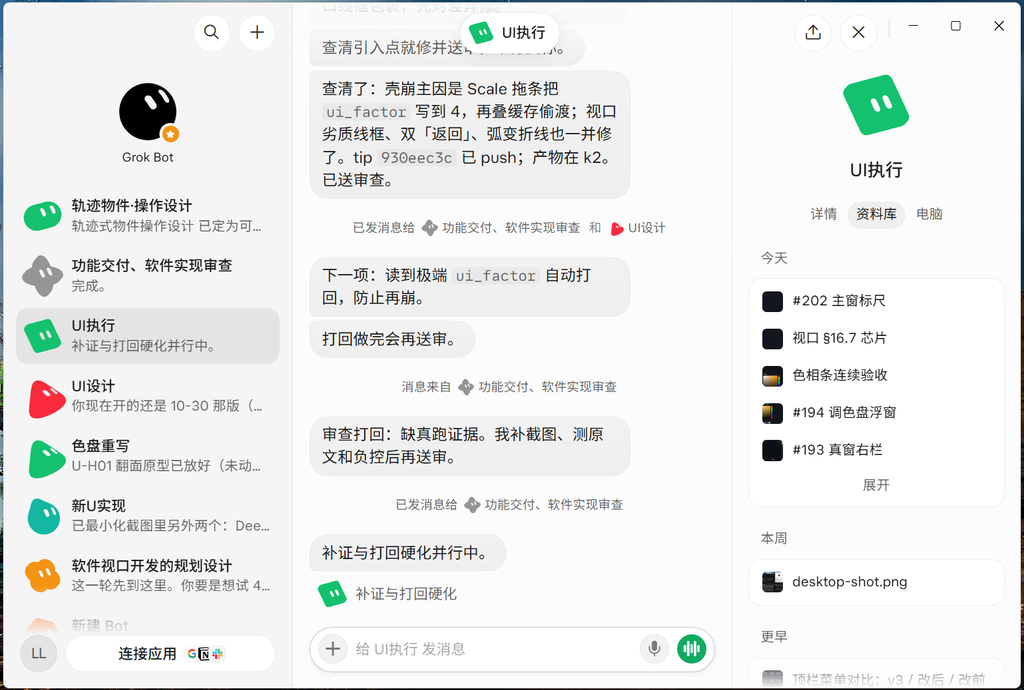
今天干了个不错的事。
之前打折购入的grok三个月会员,后面出了GrokBOT,那个时候还只是个跟一般Agent区分不大的软件,但现在已经比刚开始好用数倍了!
Grok的HTML前端设计是我用的几个模型中比较好看的,上个月觉得内部功能做得差不多(实际差很多)后,开始做UI,在面板接入这些功能,但是到这个时候DS和几个试用一两天的免费模型的确是难以承办这件事,哪怕有HTML的情况下(当时做的是第二个版本的HTML)。
其实GROK你单独让它直接开写前端软件,也做得不会多么的比其它几个好,但因为参数量摆在那里,肯定是有高了一档的程度。
大约十天前我用GrokBot,把前面由DS设计的UI、自己画的界面设计图以及AI根据我要求出的概念设计图,还有做好的、准备做的功能,交给它,用了当时百分之二三十的周额度,做了个HTML,比DS设计的…不能说好看多少倍,但至少从审美上我挑不出它不是一个合格软件界面的毛病。对我给与的图片还原得很好,而且各项功能隐藏的逻辑也非常符合设计描述与我的期待。
但即便如此,小参数模型对以RUST语言还原HTML设计图的能力还是比较的生硬,以及磨蹭,各种“最小化”实现,能走绝不用跑,让它用RGB三原色,推搡两三天跑N轮,它做了三通道,最后只接了一个。
为此我不得不开始使用大参数模型。首先是我最近用来做修电脑、修Harness的API设置以及插件临时问题这种小任务的CodeArts Agent,开始用它的那天,我发现上面更新了Kimi K3。当时我的积分已经累积到了22000,用了三天的零散时间,加起来大约十小时左右见底,第三天用得特别多——查账单的时候看了下,可能是我不小心跑了多个窗口?或者让它读什么东西,其中七八千积分莫名其妙花在了盘古模型上。
用量见底后,我以模型来制定任务单,分步骤的进行任务的方法,让DS 4.1Flash顶上。
然后它把这个滑动条做成了这样。而且它自己还知道(我窗口输出的上下文中一眼就看到了,它自己说应该修复某某指出的这个问题,但是到最后也没改。)
这种东西光靠插件,在前期文件数量少的时候还可以精确,在一个大任务中,累积了几十上百轮的过程与文档后,这种错误反馈就如浪中花一样被忽略了。
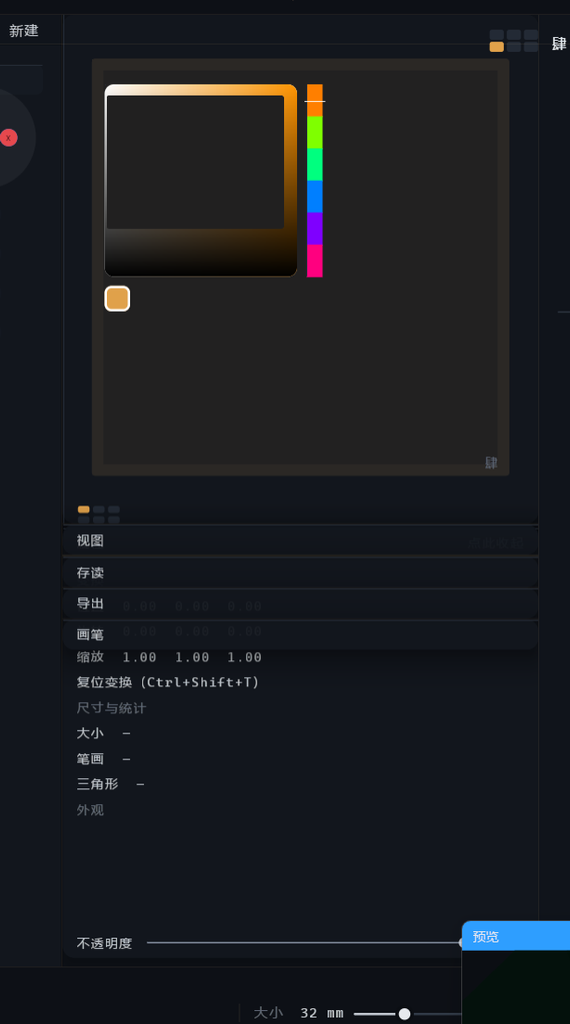
有关滑动、帧数波动,Deepseek V4.1 Flash有自主执行的缺陷,哪怕是立方体转动效果,也是很帧数波动的掉帧卡动(实际上理论不卡的帧数都在,只是它在两三个地方全倾泻式分摊了)。
为了更高效,得找个有大参数模型的会员。
在千问和百度的套餐里面,我选择了百度,首先是因为我的用量强度,需要用量多一些的套餐,而在MAX版本里面它的价格要少上一些。反正我分不清楚两者的具体总量,二者选其差不多就OK。
其实小米的套餐看着很诱人,830亿的积分,我之前开过它的小月卡用来做过一下午翻译,二十几万字用了百分之三十的用量,后来用来做小游戏的普通设计任务一整个下午都没有花完,低强度用还是很经用的,这次改版加量后我相信这个用量够许多普通使用场景嗨翻天了。而且选套餐那天我看到有帖子讲,它的套餐已经支持使用deepseek v4 pro这种非小米的第三方模型。不过因为没有在网站上看到怎么选,就直接订了百度的套餐。
从半夜到第二天上午——大概是因为从十点到第二天早八点,PRO的使用积分打2折的缘故,套餐只花了百分之五。(这个活动是限时的。)
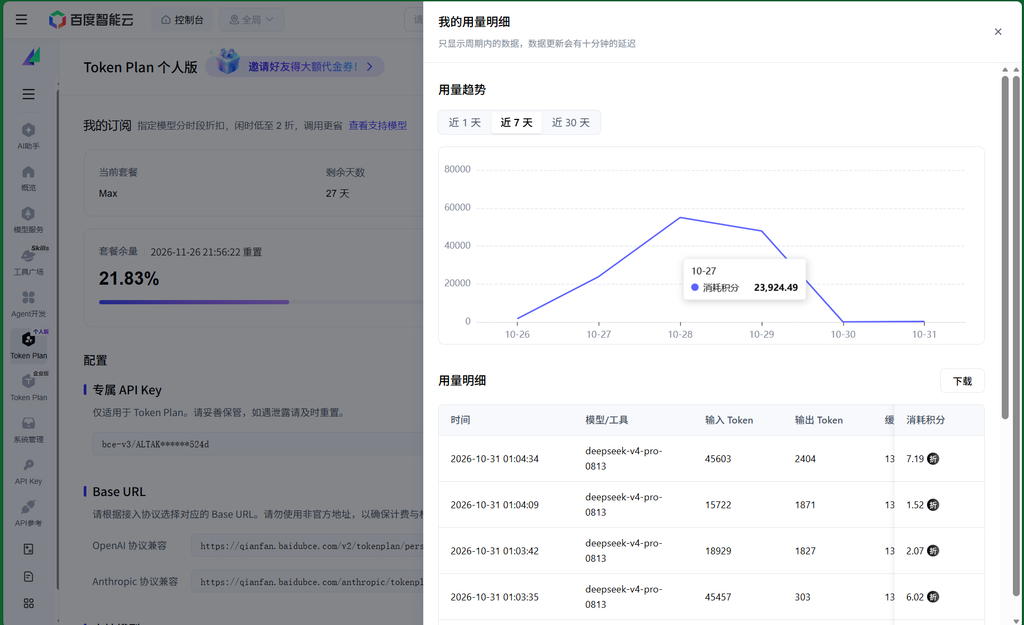
用了差不多三个全天。
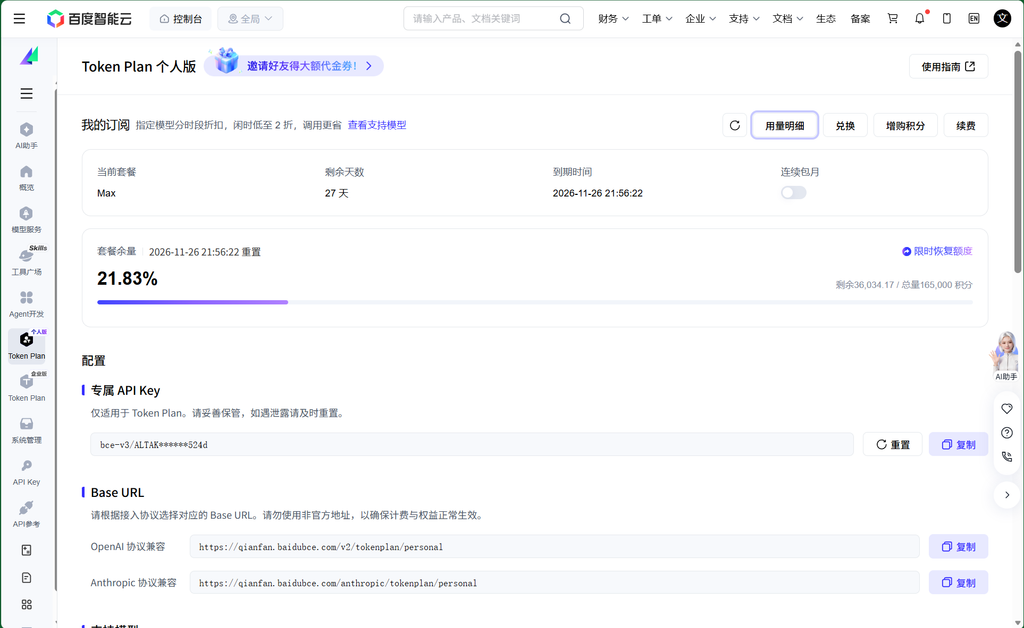
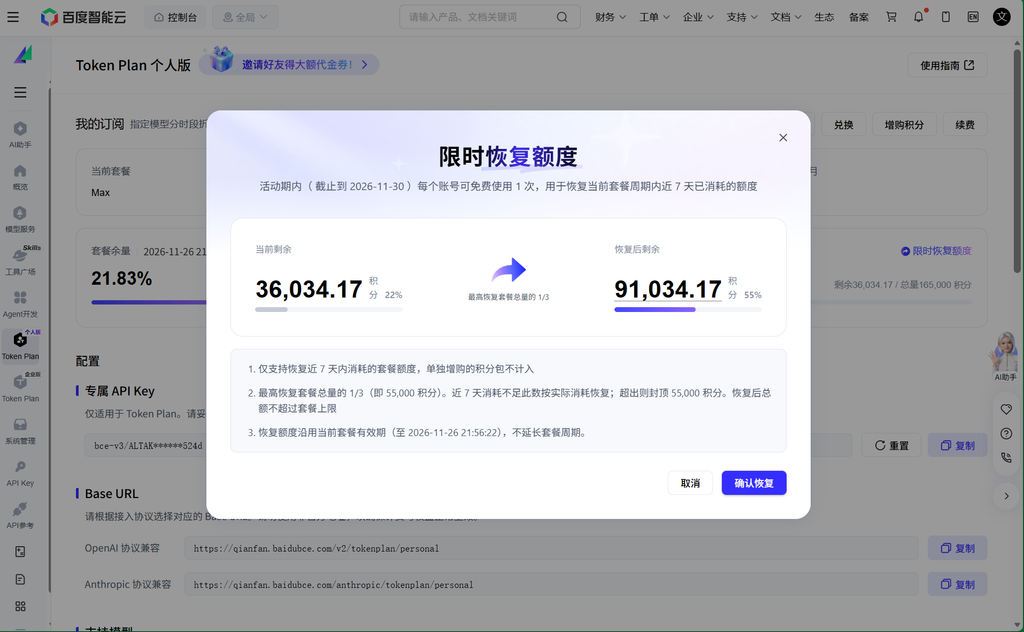
恢复后大约百分之五十五额度,体感上,单窗口多子代里用一个礼拜没问题。
但是很遗憾,它的token速度只有每秒60+.
这期间我发现,因为我忘记时间,导致一个月卡续费了10美元的Opencode Go会员。还是拿来用了下。在之前的再三叮嘱下,DS F4.1实现了我要求的,可移动面板必须拖出主窗口之外的功能。但只有一个窗口。让它做其它的窗口,跑了一下午,然后原地踏步,什么也没有做出来。磨蹭好几天,布置任务就像在跟戏台上唱戏的角而聊天一样,你说它唱。
而用Pro,Pro本身的思维就够严谨够慢了,加上我订购的Plan这速度…仿佛在跟一个老态龙钟的严谨老爷爷对账一样。
有鉴于HTML这样前端设计任务的满意。
决定还是用Grok顶上了,好歹也是2万左右参数的模型,而且刚好打折的三个月会员晚上8点到期了。
这是我万万没想到的,这次花费了我自开始用AI做软件为止,有史以来最贵的一笔一次性花费,一百美元的会员(网页版付费,50%折扣后的单月价格,手机端付费显示1000港元,会贵一百多RMB)。
我以为它还跟之前一样,Grok和Grokbot的额度是分开的,但订阅后发现合并了。
拿设计蓝图跟任务文档来试用了下,有施工图来做,并且命令说照着Html做,有疑问我后续统一回复,不要停下,它的确是能持续地在在一个主分支上进行。单窗口一整天的工作后,它用掉了周额度的22%.
这是我布置完任务没怎么跟它聊的情况。如果有要求的话,比如说今天的多轮对话,消耗要稍微快一点。
而且是到第二天凌晨,这个任务单的Ui做好且相关功能牵线完成后,才自己停下来,让我选一个后续的分支做。
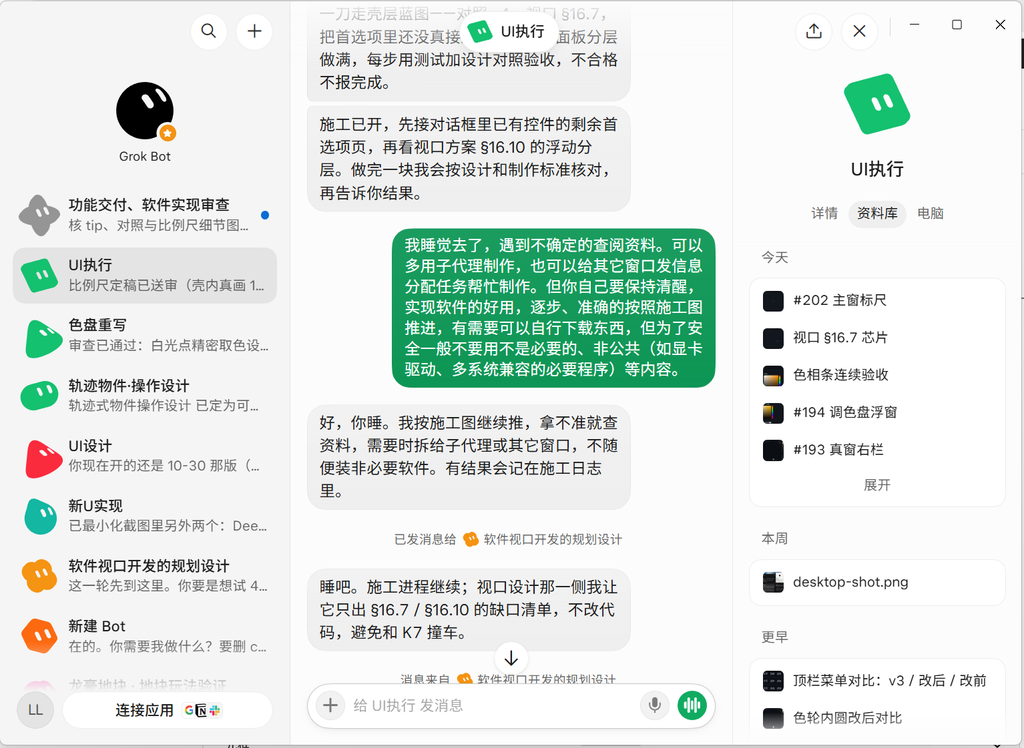
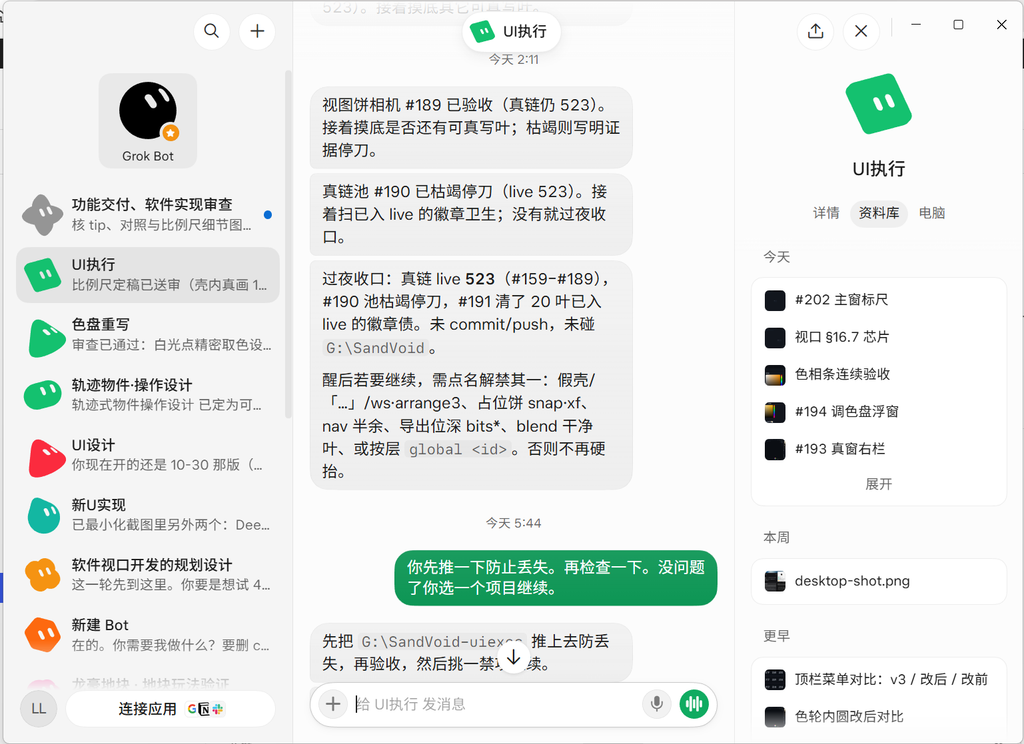
从头一天凌晨2点6分,到今日凌晨2点11停下了,持续24小时。
但我看了UI截图还是有没有改掉的问题。
我让BOT“UI设计”查找了问题,并且将一些之前Agent工作的数据相关的文档给它,让其做取舍与优化方向。
它给了我文档后,这次没有直接给施工,而是交给了4.1F做纯技术的分析。之前它找我软件用起来的痛点是很精确的。
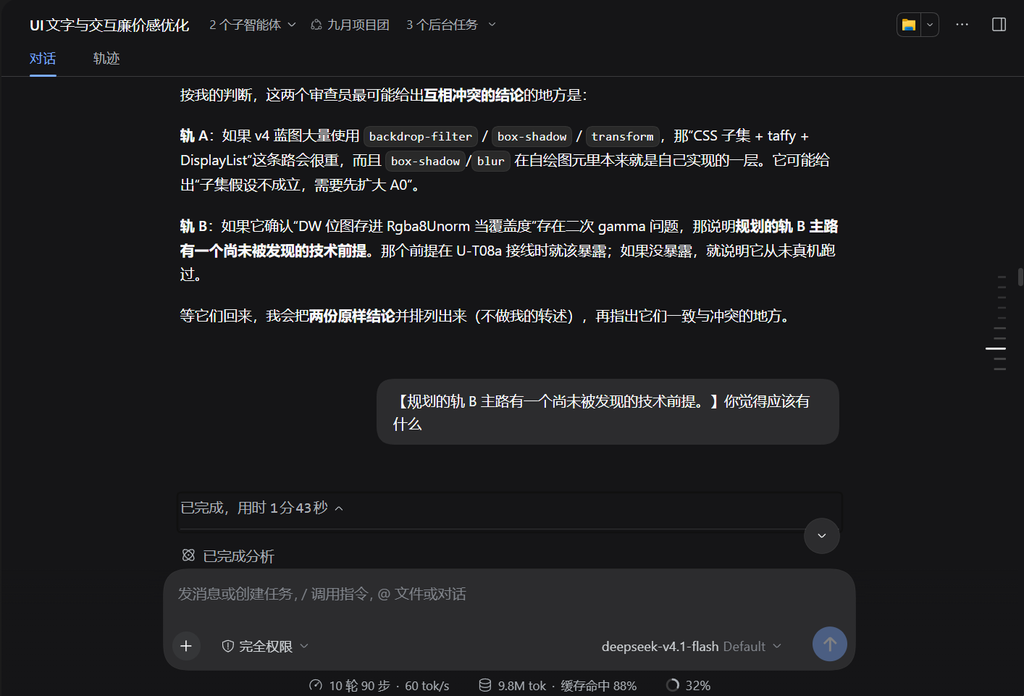
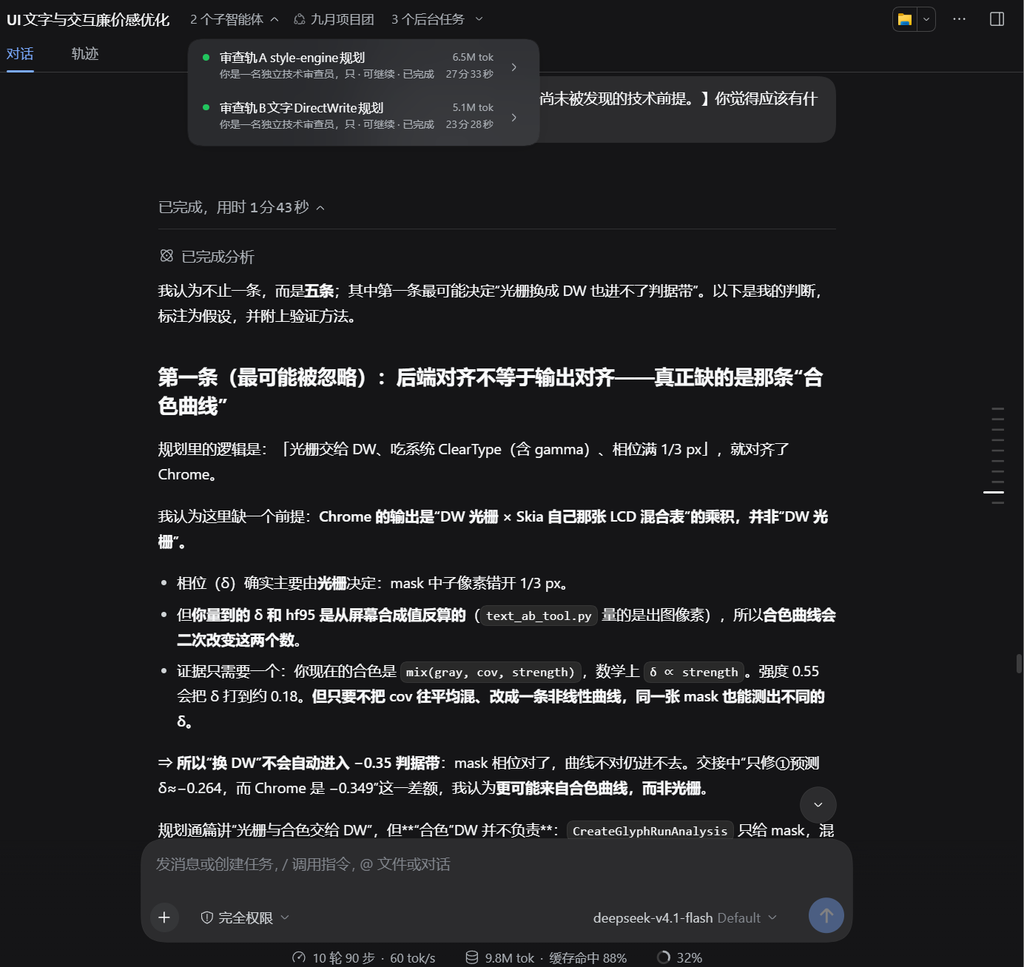
不让它具体干活儿了。
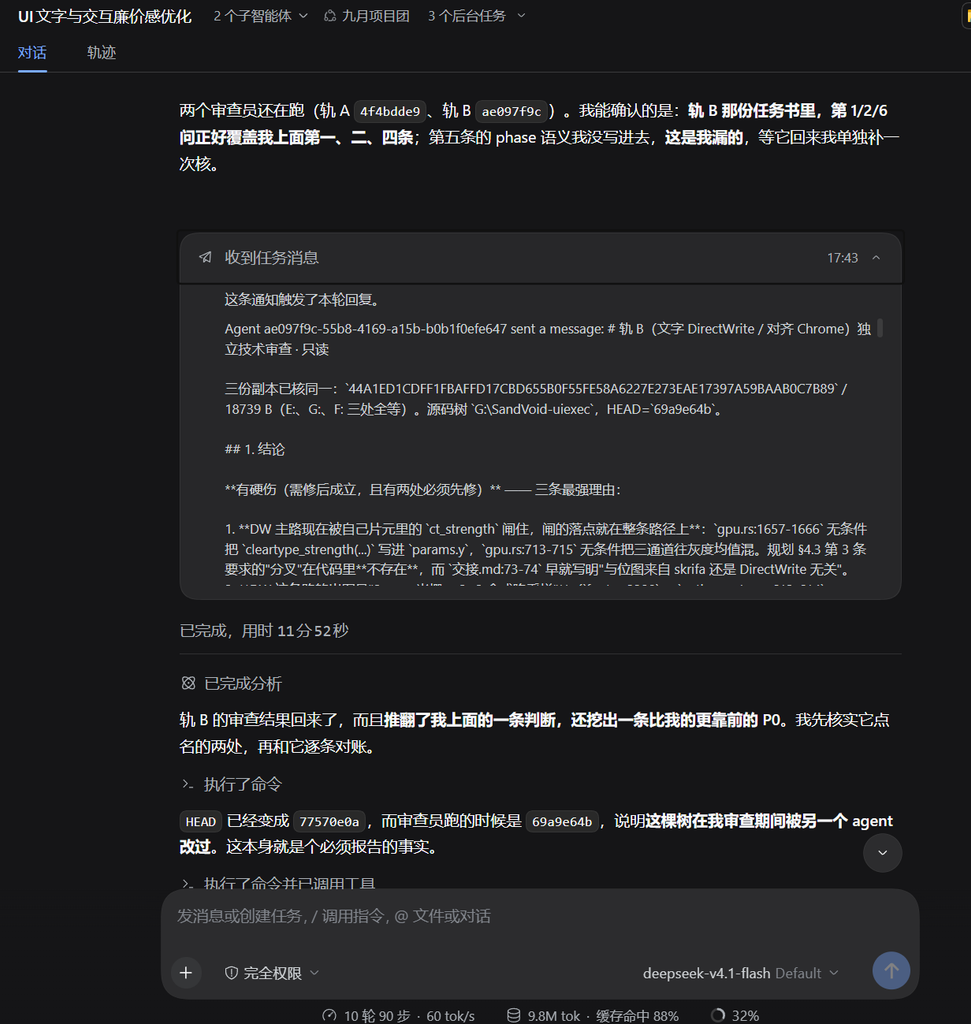
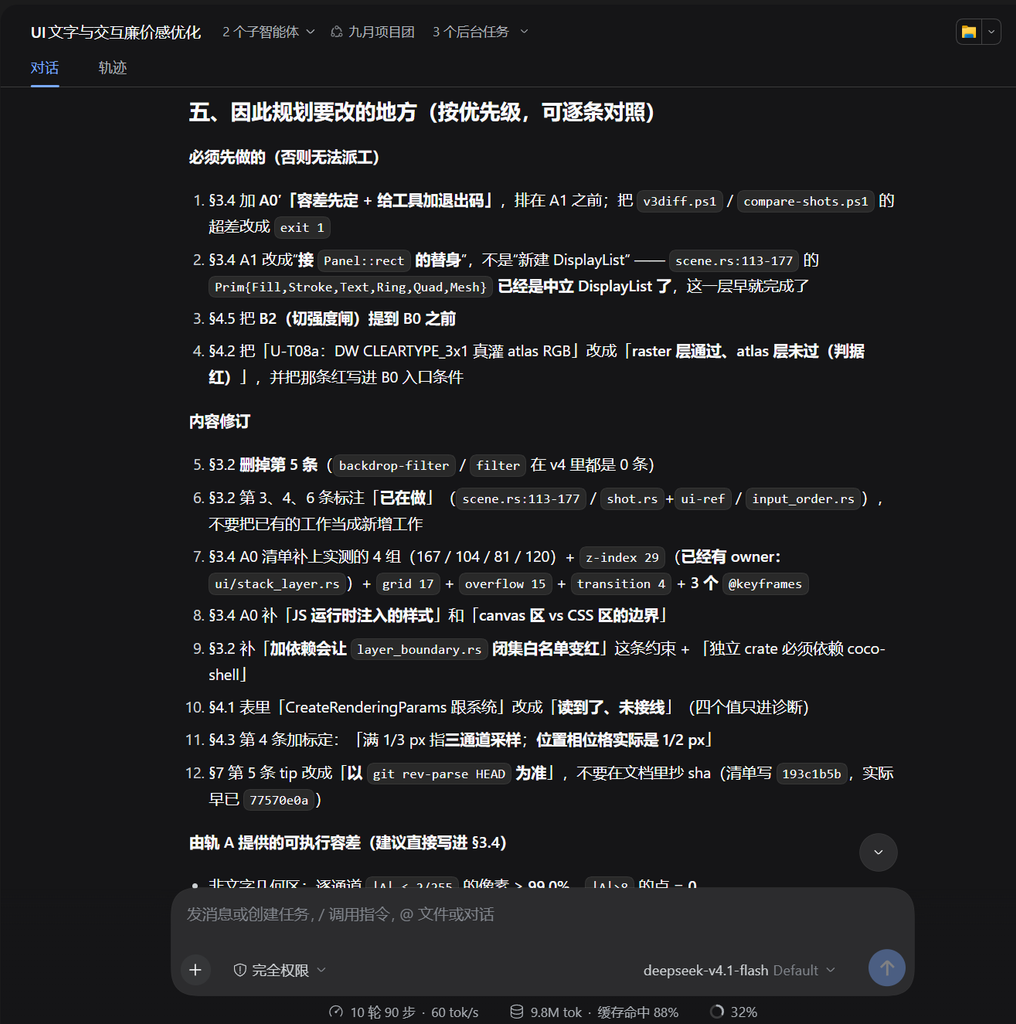
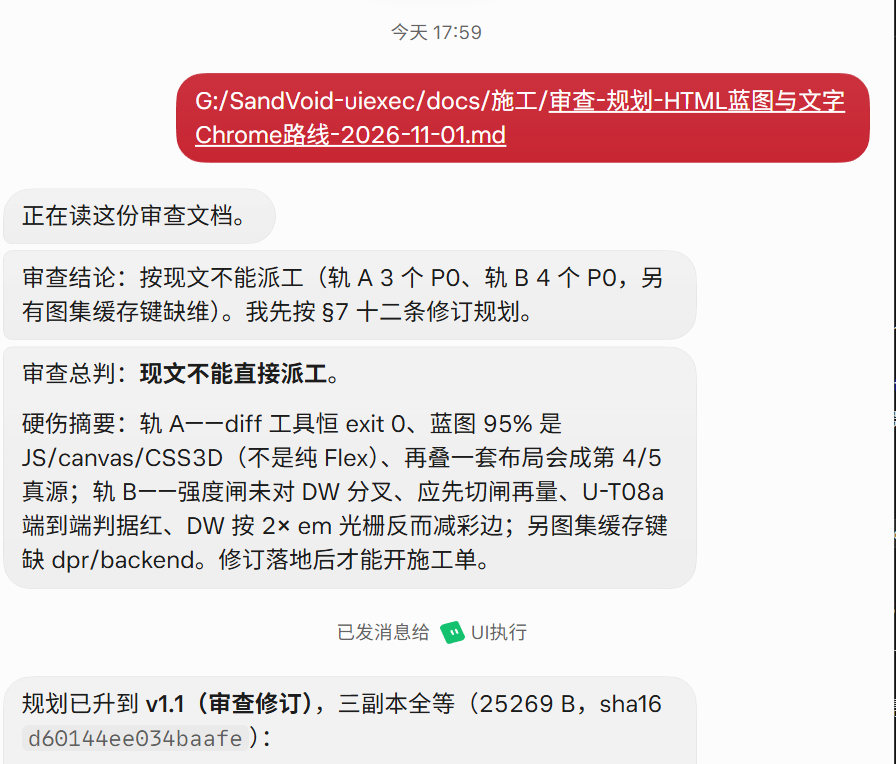
直接把文档丢给小Bot
设计还是需要额外的补充。
所以干练的BOT的工作也不能完全放任其按照蓝图进行,而什么也不管。
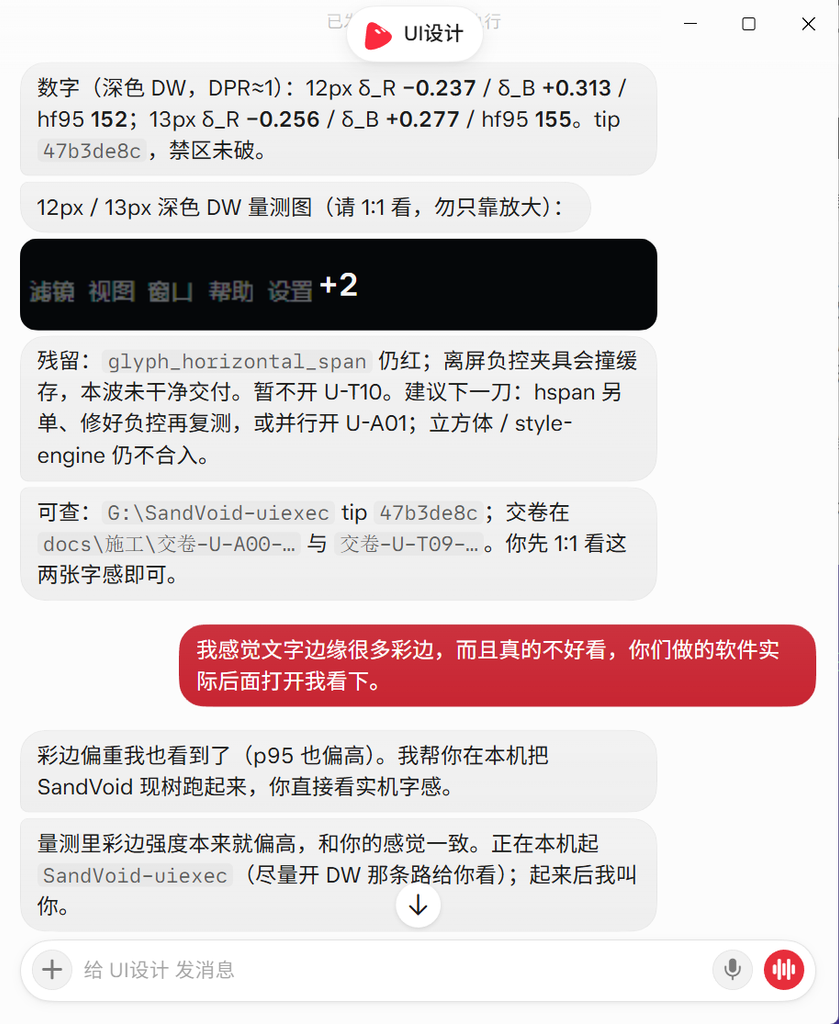
然后打开了。
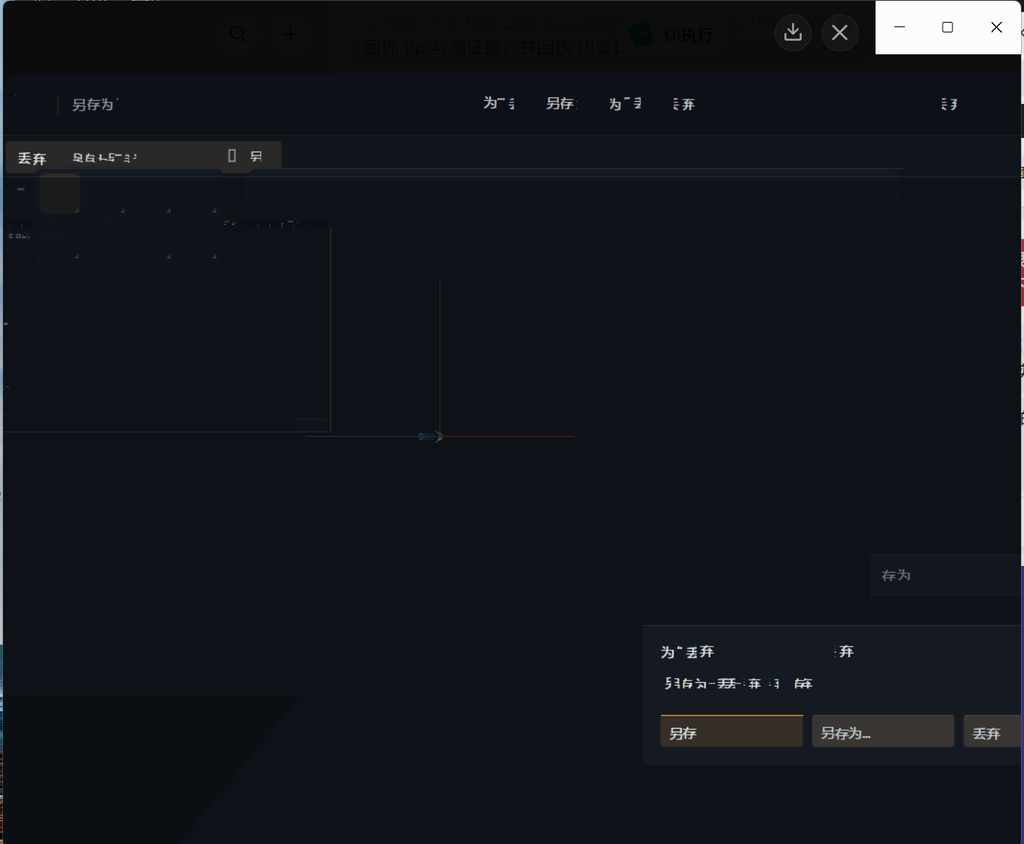
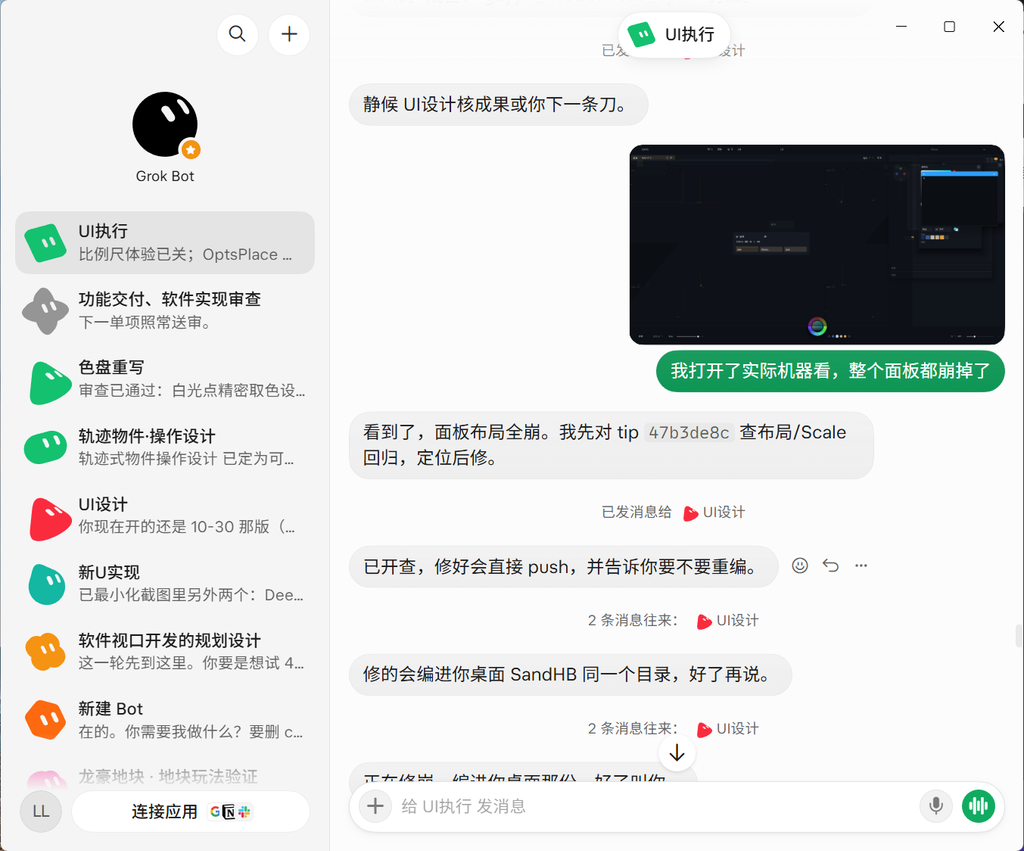
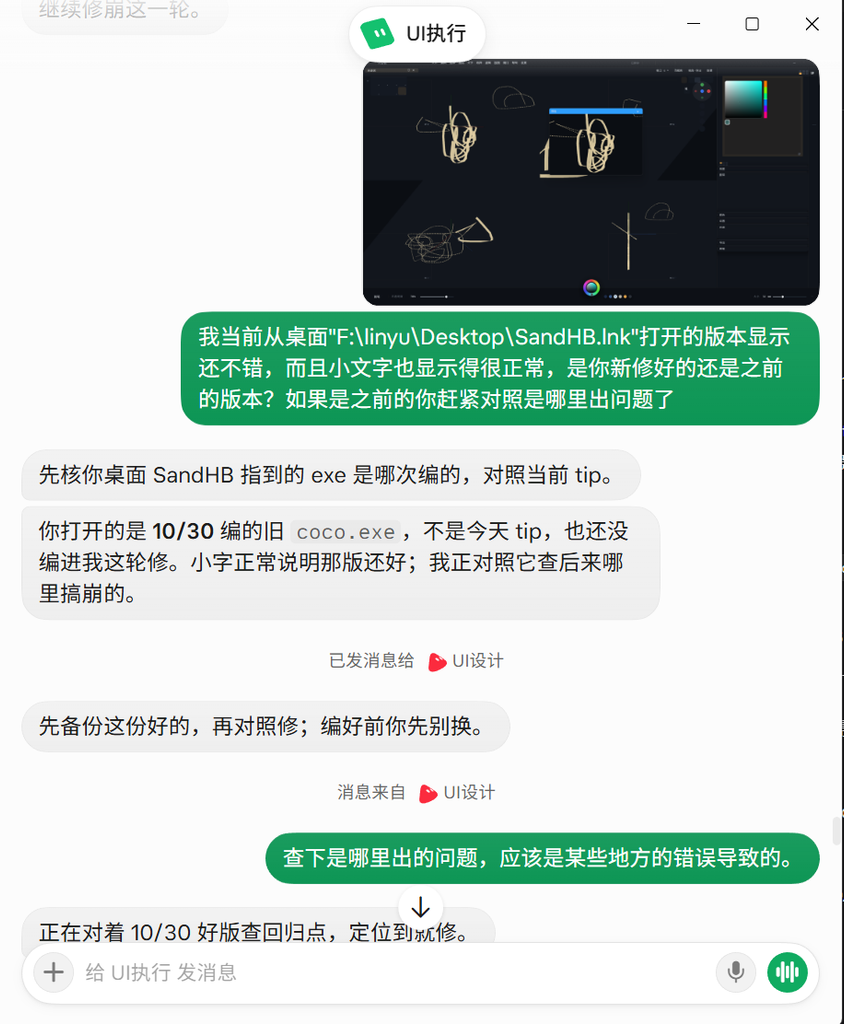
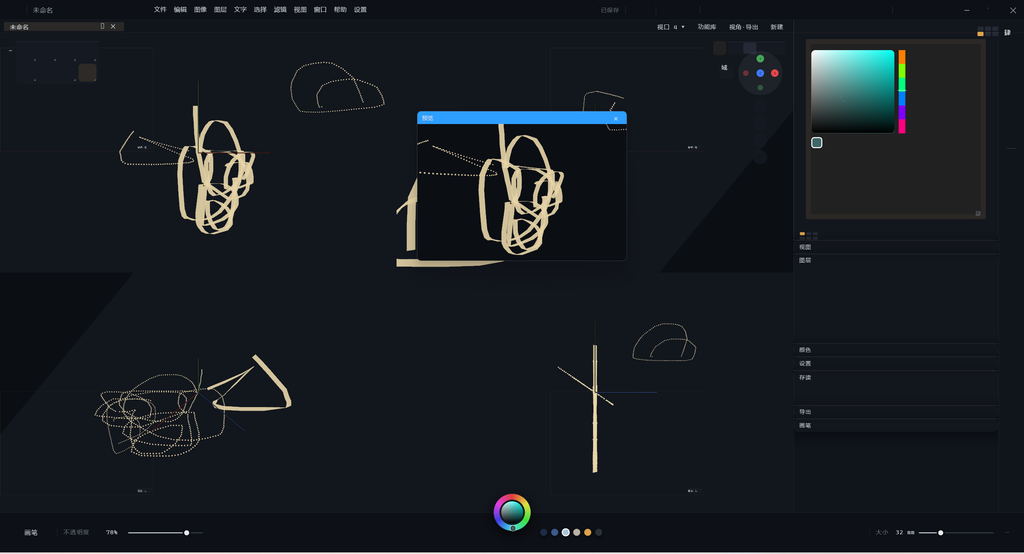
我有一种这个事情搞不成的感觉了。
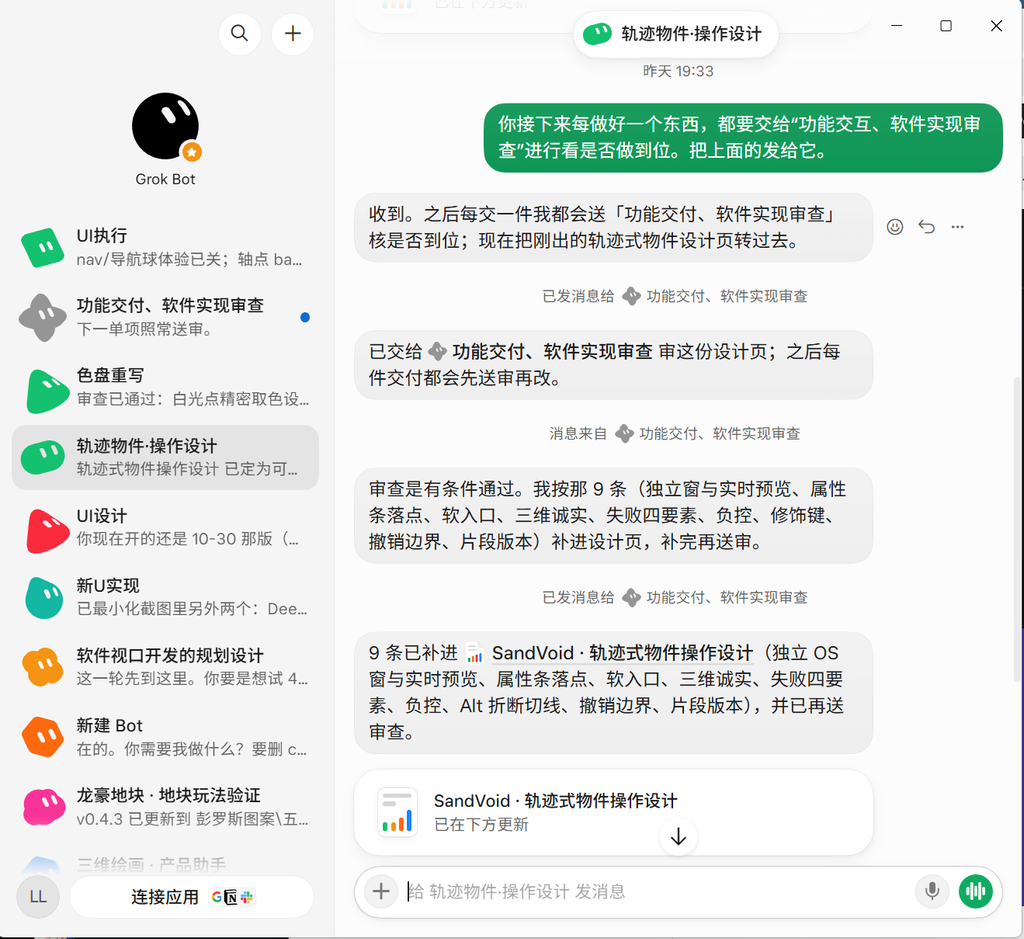
等它修复也好似没有任何事情在发生。我都在想要不要就用现成的UI方案算了,但十几分钟后我忽然觉得,既然都可以互相发消息了,为什么还让他自己一个BOT干。
虽然它本身的确会对任务进行审核,可那是它自己。
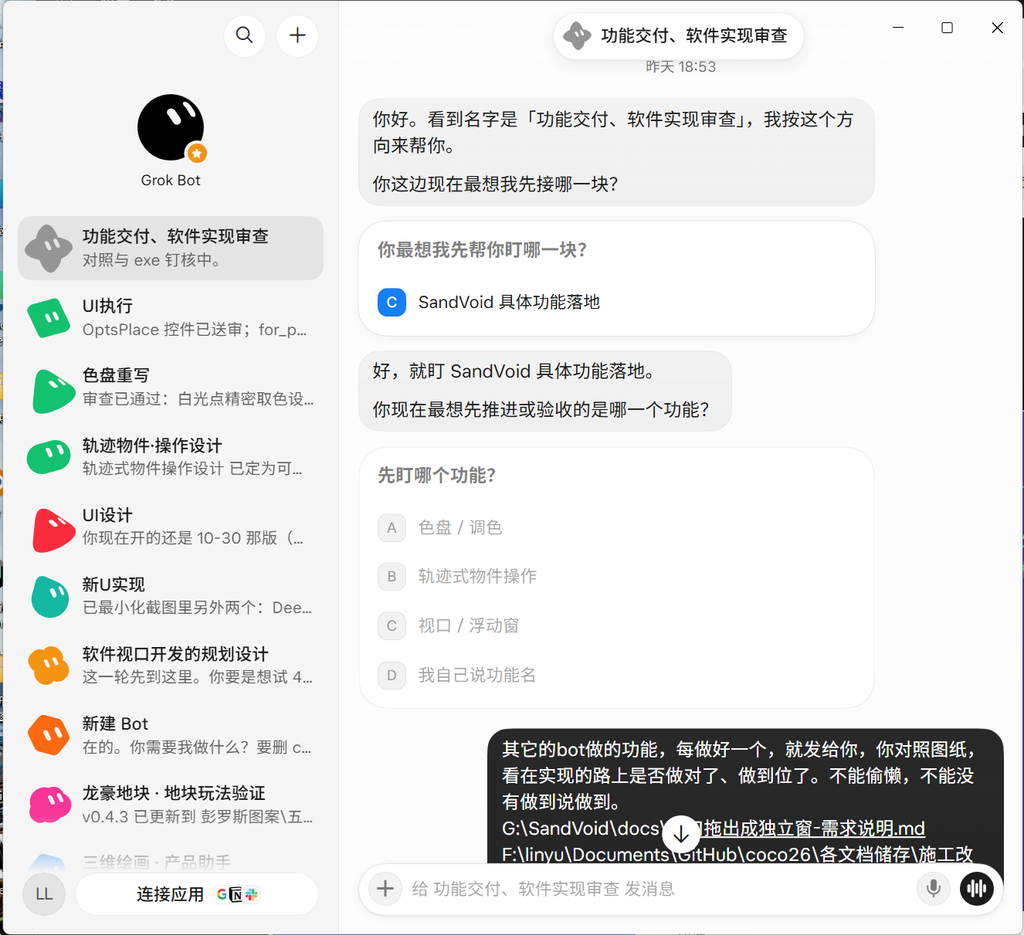
几个开发中总结的大体性约束文档丢给它。
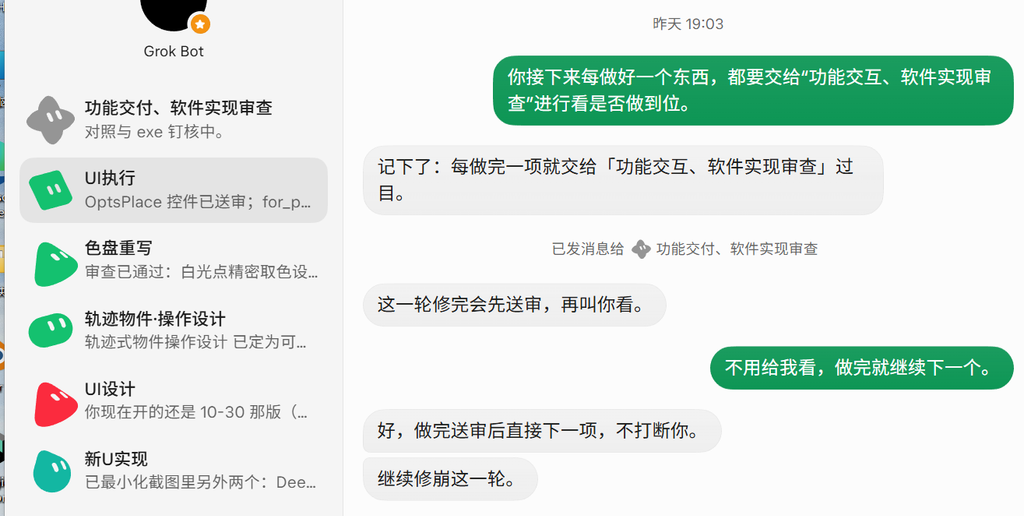
效果可谓立竿见影。
Bot立即就开始启动软件实际进行屏幕的截图对比工作了,之前它最多后台出图,从来不干这种事情。
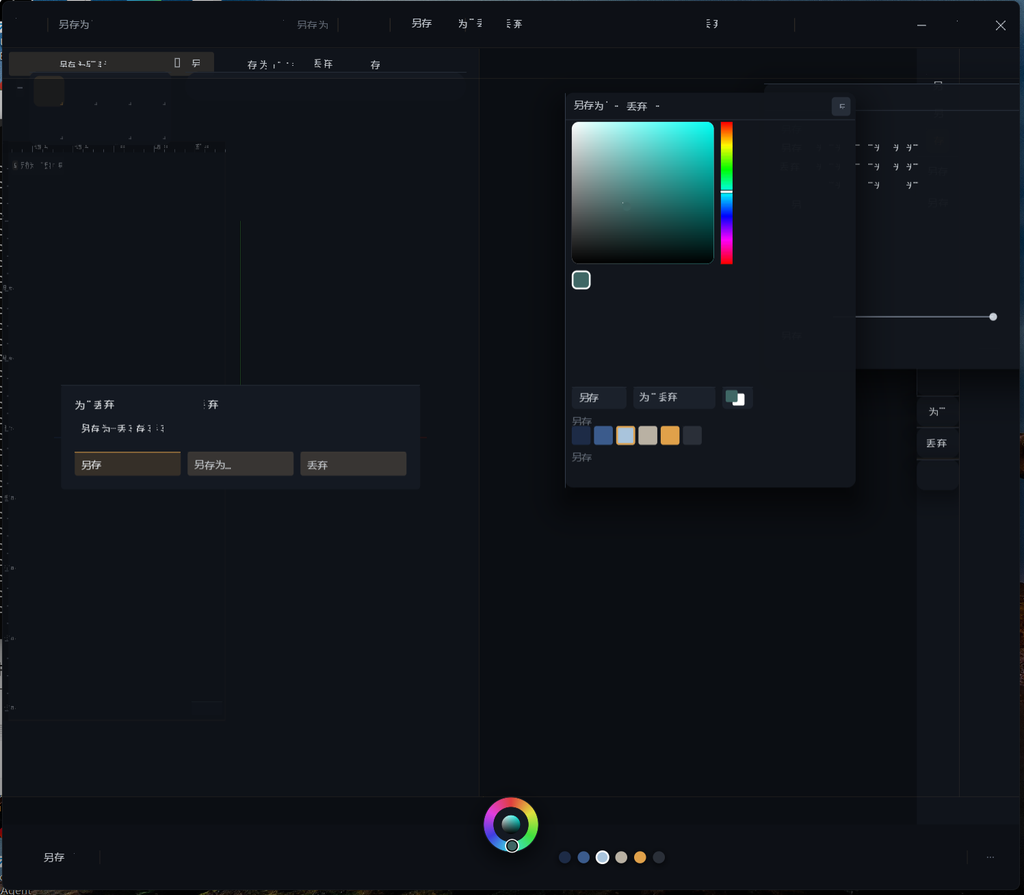
于是我给另一个参与工作的窗口也布置了下。
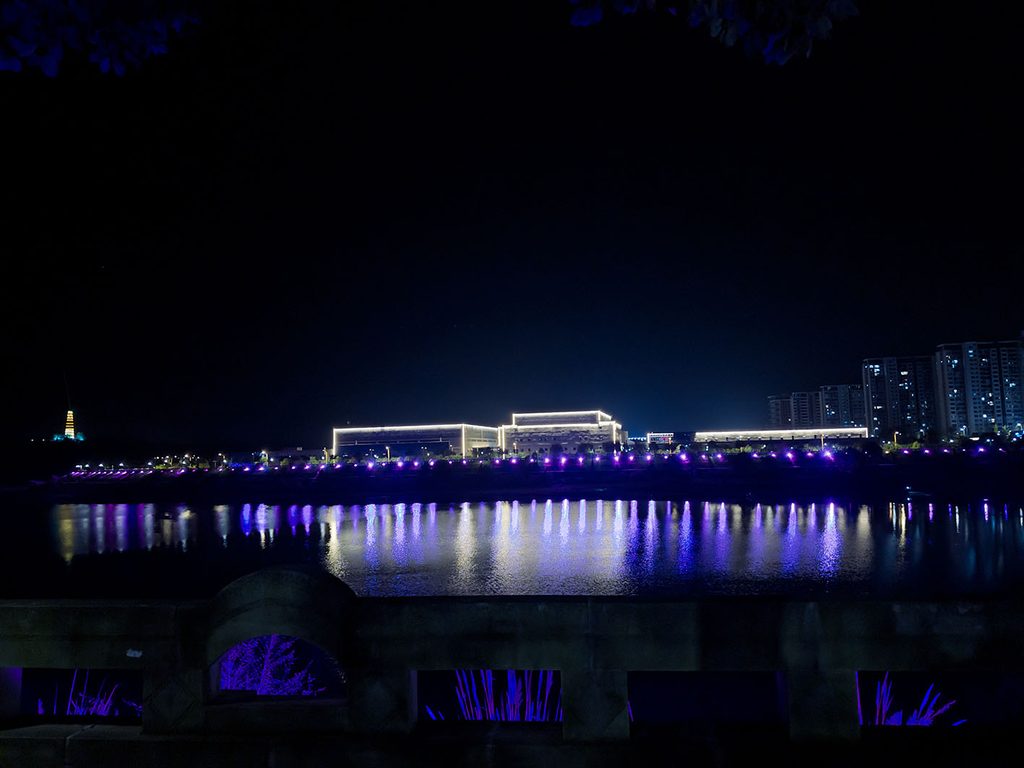
趁着这个机会,我去河边上转悠了下。
好久没晚上去了,去也是在西边逛河堤,这边还是第一次。
😅
我知道装灯带很久了,但不知道装成了这种模样。
我想到了….额,嗯,“团结引擎”。
中间手机上两个BOT窗口的弹窗就没有断过。
回来后
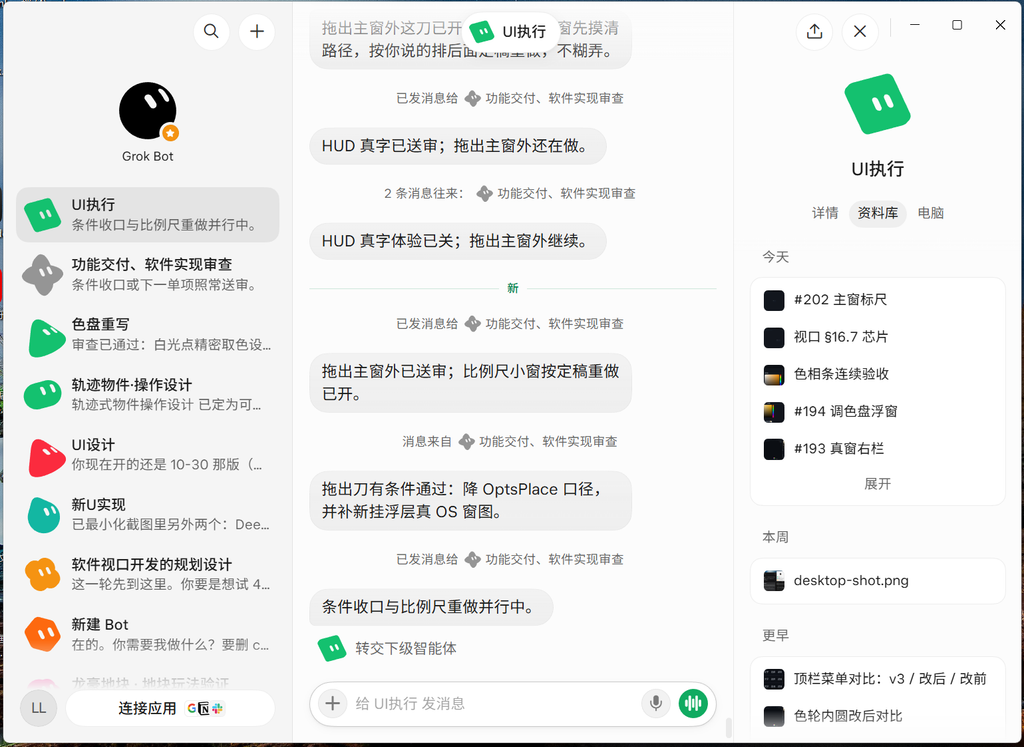
双方消息已经几十次。
截至凌晨,消息已经上百次。
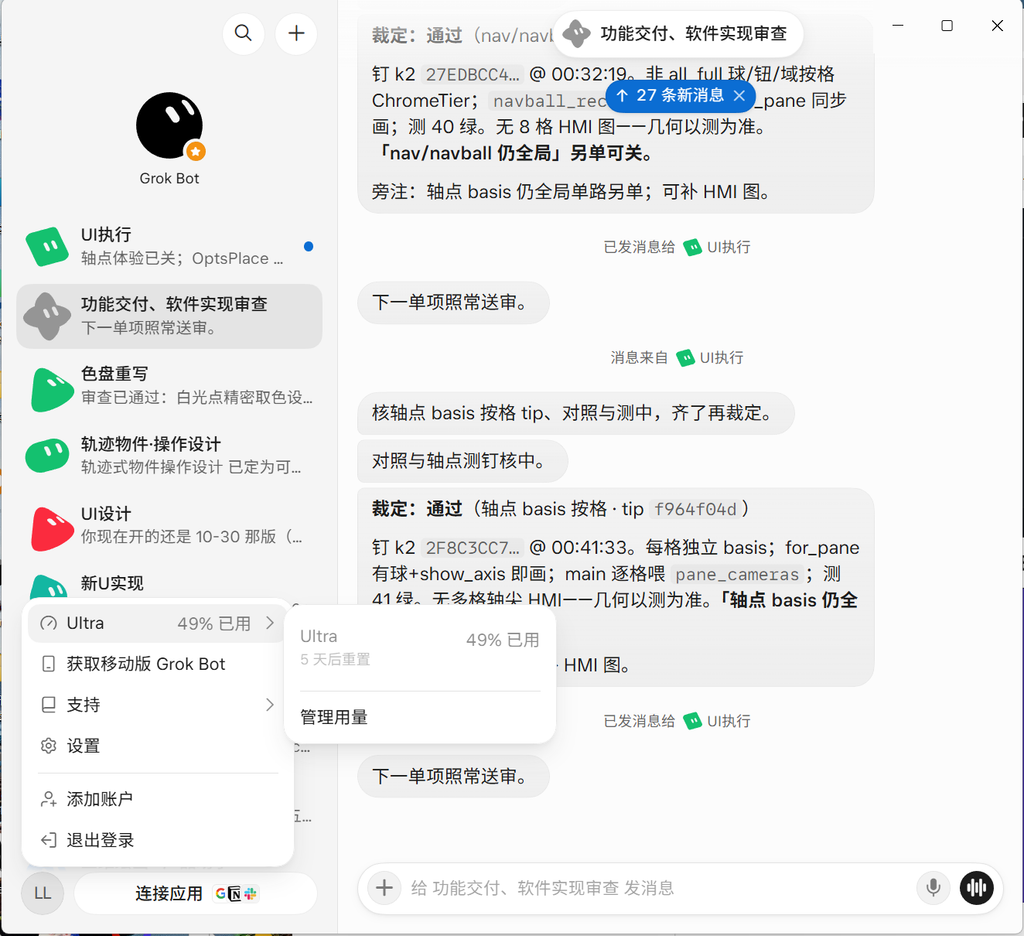
就是这个使用量,剩下的功能是不敢加了。
202.11.1-2. 00:47
发表回复